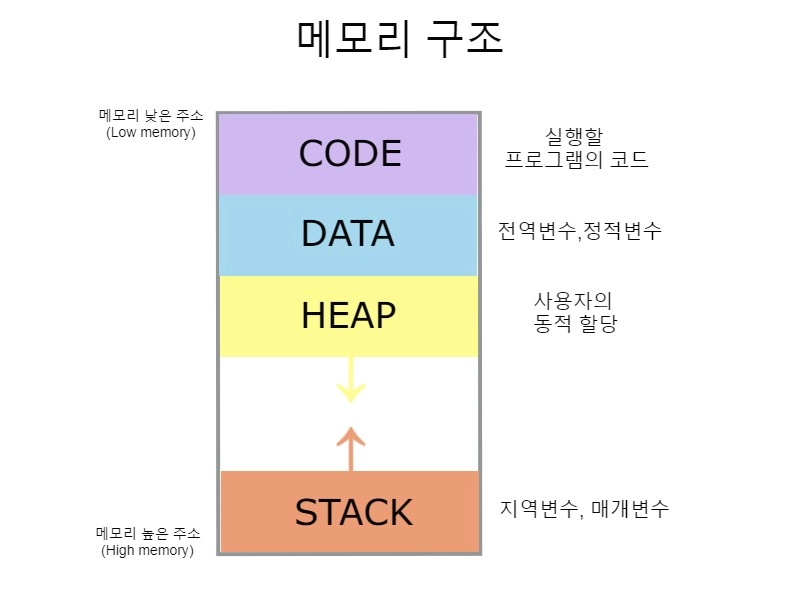
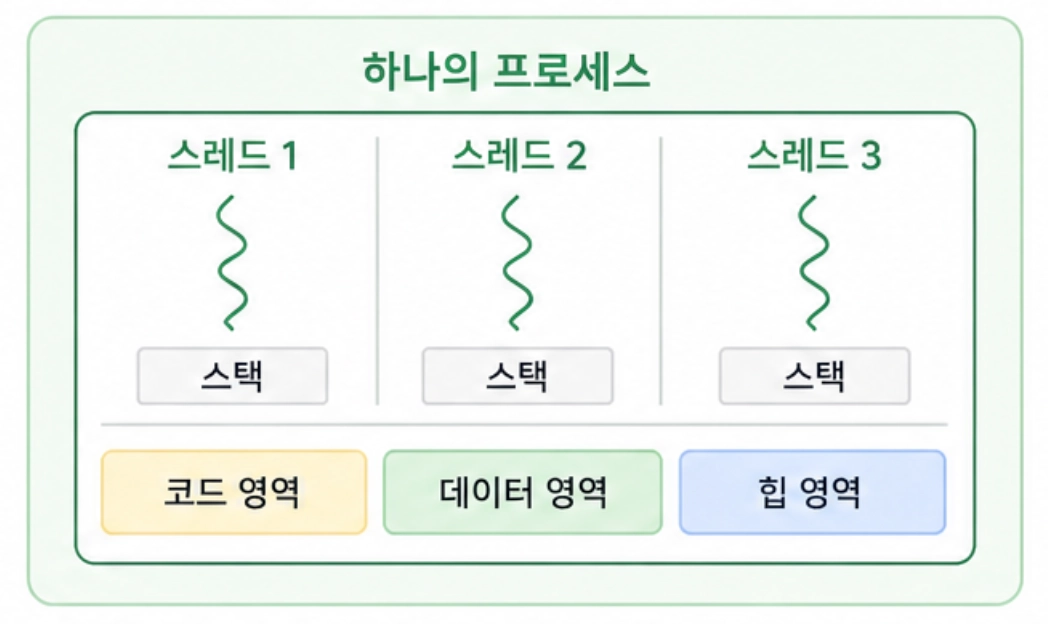
스레드끼리는 Code·Data·Heap을 공유하고 Stack·PC·레지스터는 각자 가집니다. 프로세스끼리는 메모리를 공유하지 않아 IPC(파이프, 소켓, 공유 메모리)가 필요합니다.
같은 프로세스의 스레드가 공유하는 영역과 각자의 스택
보완스레드 전환이 싼 이유는 같은 주소 공간을 쓰기 때문입니다. 프로세스 전환은 페이지 테이블 교체와 TLB 무효화가 따라와 비용이 큽니다. 반대로 프로세스는 하나가 죽어도 다른 프로세스에 영향이 없다는 격리 장점이 있습니다.
비유
집과 가족
프로세스는 집, 스레드는 그 집에 사는 가족이에요.
가족은 냉장고와 거실(Heap)을 같이 쓰지만, 각자 자기 일기장(Stack)이 있어요. 옆집 냉장고는 열 수 없어서 전화(IPC)로 물어봐야 해요.
가족 한 명이 이사 오는 건 새 집을 짓는 것보다 훨씬 쉽고 빨라요. 서버가 요청마다 집 대신 가족을 늘리는 이유예요.
집→프로세스
가족→스레드
같이 쓰는 냉장고→Heap
각자 일기장→Stack
옆집에 전화→IPC
예시
// 한 JVM 프로세스 안에서 두 스레드가 같은 Heap 객체(list)를 공유
List<String> list = Collections.synchronizedList(new ArrayList<>());
Thread a = new Thread(() -> list.add("A"));
Thread b = new Thread(() -> list.add("B"));
a.start(); b.start();
a.join();  b.join();
System.out.println(list);   // [A, B] 또는 [B, A]
기술 도메인
Tomcat: 한 프로세스 + 요청당 스레드(thread-per-request)
Nginx: master 프로세스 + CPU 코어 수만큼의 worker 프로세스, 각 worker는 이벤트 루프
PostgreSQL: 연결마다 프로세스를 띄움 → 커넥션 풀(PgBouncer)이 중요
Chrome: 탭마다 프로세스를 분리해 한 탭이 죽어도 나머지는 살아 있음
테이블
비교·정리 표
용어
정의
프로그램
디스크에 저장된 실행 파일
프로세스
메모리에 올라가 실행 중인 프로그램. 자원 할당 단위
스레드
프로세스 안의 실행 흐름. CPU 스케줄링(실행) 단위
동시성 문제
이론
경쟁 상태(Race Condition): 실행 순서에 따라 결과가 달라지는 상황
임계 구역(Critical Section): 공유 자원에 접근하는 코드 영역
동기화: 임계 구역에 한 번에 한 스레드만 들어가게 통제 (synchronized, ReentrantLock)
보완동시성 문제는 원자성만이 아닙니다. 한 스레드가 바꾼 값이 다른 스레드에 보이지 않는 가시성 문제도 있고, 이는 volatile로 해결합니다. 단, volatile은 count++ 같은 복합 연산의 원자성은 보장하지 않습니다.
비유
칠판에 쿠키 개수 적기
쿠키 통 옆 칠판에 "100개"라고 적혀 있어요. 두 친구가 동시에 칠판을 보고 쿠키를 하나씩 넣은 뒤 둘 다 "101"이라고 고쳐 적었어요. 실제로는 102개인데 칠판에는 101개예요.
그래서 규칙을 정해요. "칠판 앞에는 열쇠를 가진 한 명만 설 수 있어요." 이 열쇠가 락이에요.
칠판→공유 변수
칠판 앞 자리→임계 구역
동시에 고쳐 쓰기→경쟁 상태
한 명만 쓰는 열쇠→synchronized, Lock
예시
count++는 읽기 → 더하기 → 쓰기 3단계입니다. 두 스레드가 동시에 100을 읽으면 둘 다 101을 써서 결과는 102가 아니라 101이 됩니다.
// ❌ 경쟁 상태
private int count = 0;
public void increase() { count++; }

// ✅ 방법 1: 락
public synchronized void increase() { count++; }

// ✅ 방법 2: CAS 기반 원자 연산 (락 없이)
private final AtomicInteger count = new AtomicInteger();
public void increase() { count.incrementAndGet(); }
기술 도메인
재고 차감·좌석 예매: DB 비관적 락(SELECT … FOR UPDATE), JPA 낙관적 락(@Version), Redis 분산 락(Redisson)
Spring 빈은 기본이 싱글톤이라 모든 요청 스레드가 같은 객체를 씁니다. 빈에 변경 가능한 필드를 두면 바로 경쟁 상태가 됩니다.
동기·비동기 / 블로킹·논블로킹
이론
서로 다른 두 축입니다.
동기/비동기: 작업 완료를 누가 신경 쓰는가. 호출한 쪽이 결과를 받아 이어서 처리하면 동기, 완료 처리를 콜백 등에 넘기면 비동기.
블로킹/논블로킹: 호출된 함수가 제어권을 언제 돌려주는가. 끝날 때까지 붙잡으면 블로킹, 바로 돌려주면 논블로킹.
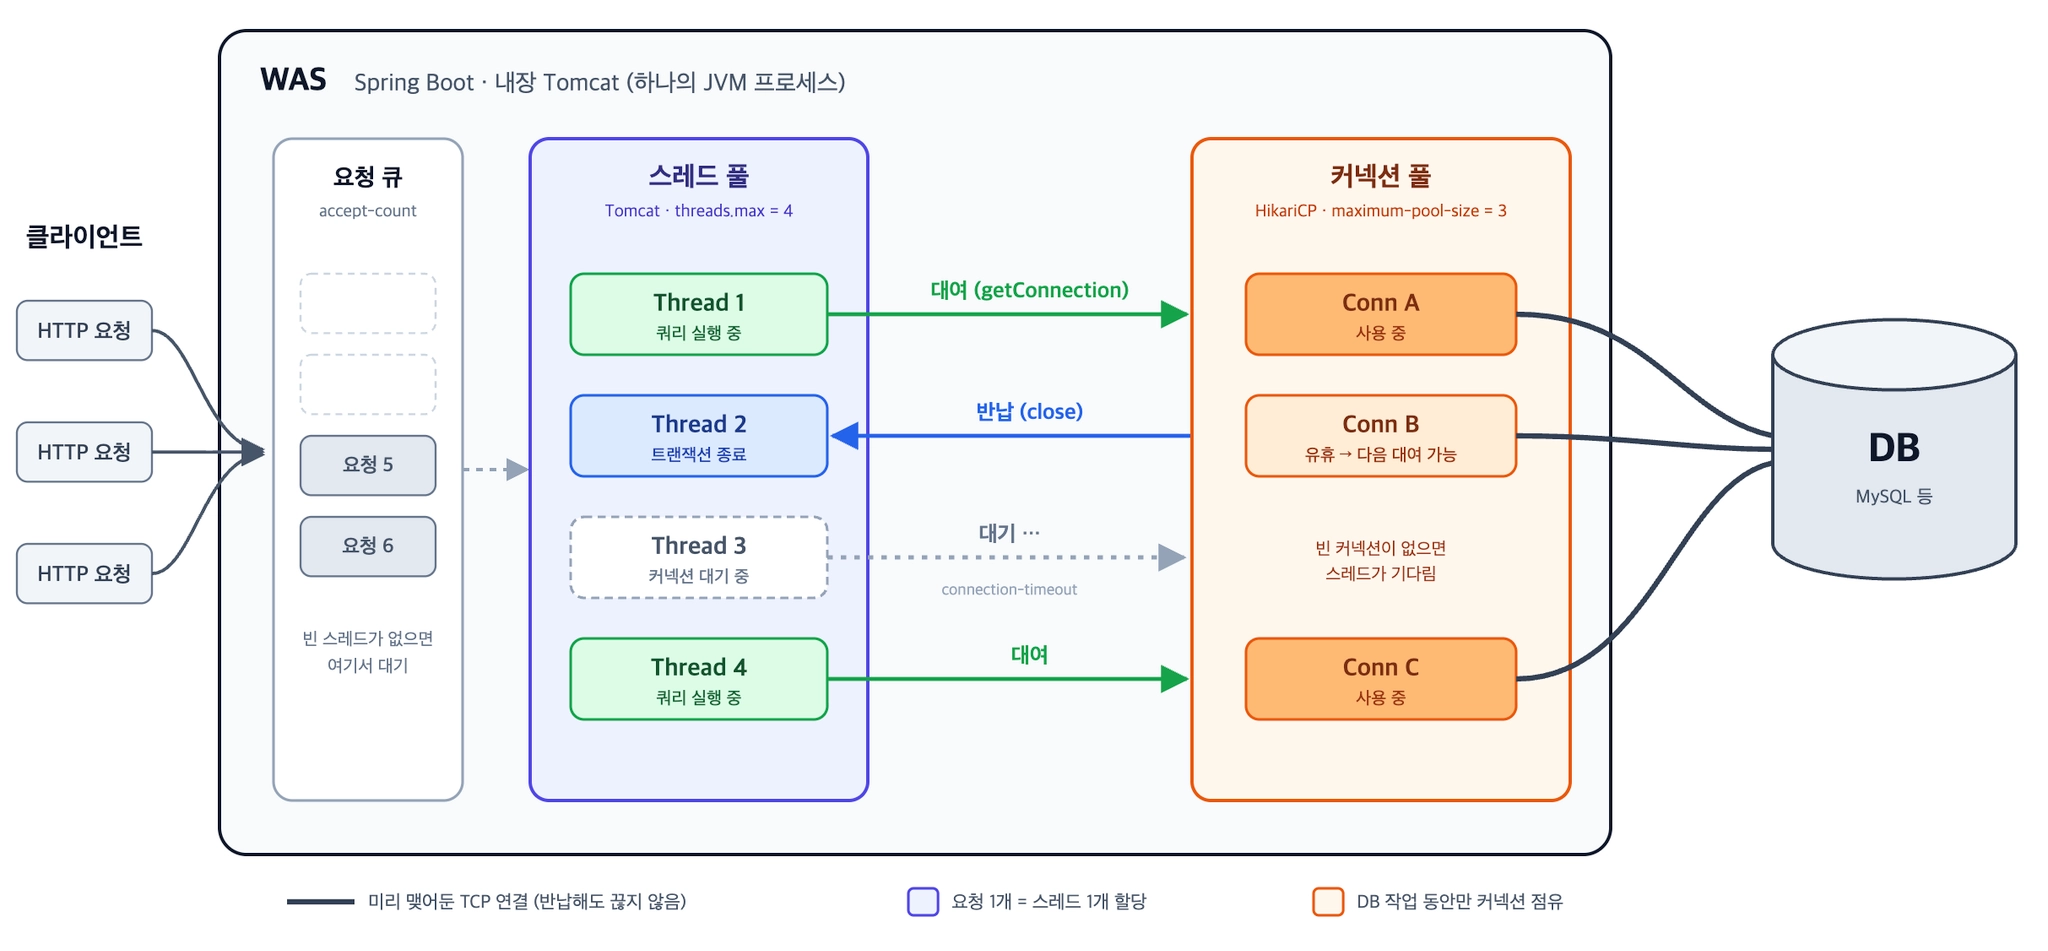
동기 블로킹 서버에서 DB 조회가 200ms 걸리면, 그동안 스레드는 CPU를 거의 안 쓰면서도 점유됩니다. 동시 요청이 스레드 수를 넘으면 큐에서 대기하고, 큐도 차면 연결 거부나 타임아웃이 납니다.
보완Spring Boot 내장 Tomcat 기본값은 최대 스레드 200(server.tomcat.threads.max), 대기 큐 100(server.tomcat.accept-count)입니다. 이벤트 루프 방식은 OS의 I/O 멀티플렉싱(Linux epoll, macOS kqueue) 위에서 동작합니다.
비유
라면 끓이기
동기 + 블로킹: 물이 끓을 때까지 냄비만 쳐다봐요.
동기 + 논블로킹: 그림을 그리다가 계속 와서 "끓었나?" 확인해요.
비동기 + 논블로킹: 주전자 알람을 켜 두고 그림을 그려요. "삐~" 하면 그때 가요.
비동기 + 블로킹: 알람을 켜 놓고도 냄비 앞에 서서 기다려요.
선생님 200명이 모두 냄비만 쳐다보고 있으면, 새로 온 친구를 봐줄 선생님이 없어요. 이게 스레드 풀 고갈이에요.
선생님→스레드
물 끓이기→DB 조회, 외부 API
알람→콜백
예시
// 비동기 + 논블로킹: 두 외부 호출을 동시에 보내고, 둘 다 끝나면 합침
CompletableFuture<User>  user  = CompletableFuture.supplyAsync(() -> userApi.get(id));
CompletableFuture<Point> point = CompletableFuture.supplyAsync(() -> pointApi.get(id));

user.thenCombine(point, MyPage::new)
    .thenAccept(page -> log.info("done: {}", page));   // 완료 시 콜백

// 비동기 + 블로킹 (안티패턴): 맡겨 놓고 바로 기다림
User u = user.get();
기술 도메인
동기가 충분: 일반 CRUD API (Spring MVC + JPA/JDBC). 코드가 읽기 쉽고 디버깅이 쉬움
비동기가 유리: 채팅·알림, API 게이트웨이(Spring Cloud Gateway는 Netty 기반), 외부 API를 많이 호출하는 서버 (WebFlux + R2DBC, Node.js)
비동기는 상위 호환이 아니라, I/O 대기가 길고 동시 연결이 많을 때 고르는 도구입니다.
테이블
비교·정리 표
조합
동작
예
동기 + 블로킹
끝날 때까지 기다림
JDBC 쿼리
동기 + 논블로킹
멈추지 않지만 완료 여부를 직접 반복 확인
논블로킹 소켓 + polling
비동기 + 블로킹
맡겨 놓고 결국 기다림 (대개 안티패턴)
Future.get()
비동기 + 논블로킹
맡기고 다른 일, 완료 시 콜백
Netty, WebFlux, Node.js
3. Java JVM · GC · THREAD
Java는 안정적인 멀티스레드, Spring 생태계, JVM 덕분에 서버 개발의 주력 언어입니다. 여기서는 문법보다 서버가 도는 환경으로서 봅니다.
JVM 실행 구조
이론
javac가 소스를 JVM 바이트코드(.class)로 컴파일
클래스 로더가 .class를 메모리에 적재
실행 엔진이 인터프리터로 실행하다가, 자주 쓰이는(hot) 코드는 JIT 컴파일러가 네이티브 코드로 바꿔 캐싱
그래서 Java 프로그램은 플랫폼 독립적이고, JVM은 플랫폼 종속적입니다. ("Write Once, Run Anywhere")
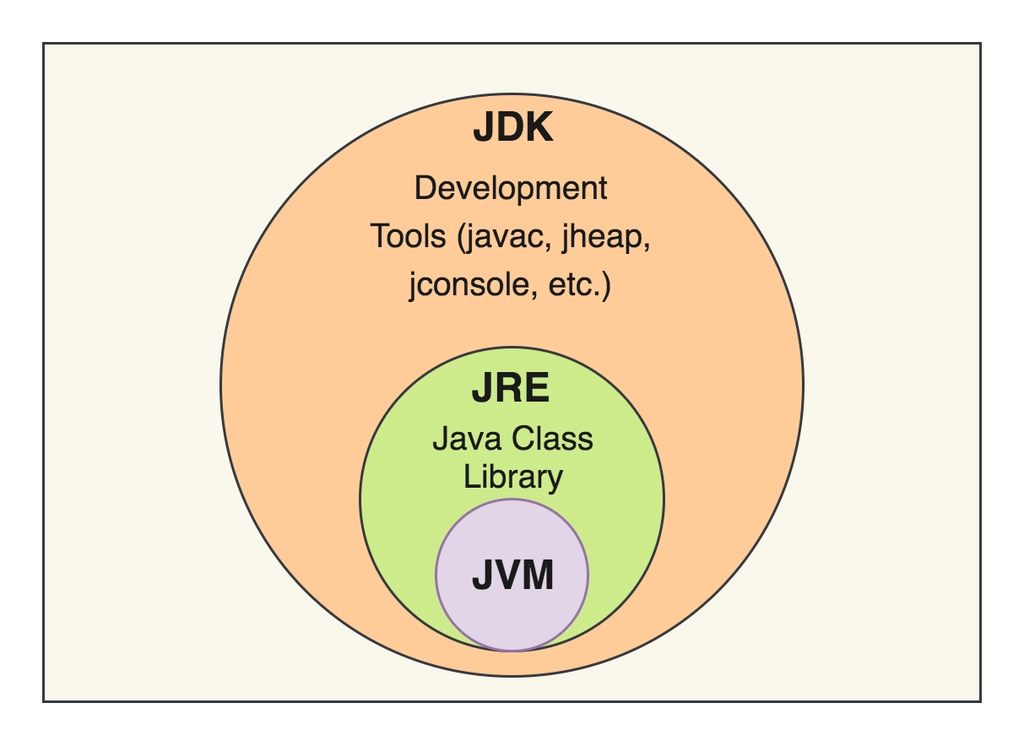
JVM: 바이트코드 실행
JRE: JVM + 표준 라이브러리 (실행 환경)
JDK: JRE + 개발 도구 (javac, jar, javap, jlink 등)
JDK · JRE · JVM의 관계
보완Oracle은 Java 11부터 JRE를 따로 배포하지 않습니다. 지금은 JDK를 설치하거나, jlink로 필요한 모듈만 담은 런타임을 만들어 씁니다.
비유
통역사와 그림책
Java 코드는 어느 나라에서나 읽을 수 있는 공통 그림책(바이트코드)으로 만들어요. 나라마다 있는 통역사(JVM)가 그 나라 말로 읽어 줘요.
통역사는 자주 읽는 페이지를 아예 외워 버려서 다음엔 더 빨리 읽어요(JIT).
공통 그림책→바이트코드(.class)
나라별 통역사→OS별 JVM
외워 버리기→JIT 컴파일
통역사 + 사전→JRE
그림책 만드는 도구 상자까지→JDK
예시
$ javac Main.java        # Main.class (바이트코드) 생성
$ java Main              # JVM이 Main.class 실행
$ javap -c Main          # 바이트코드 확인: aload_0, invokevirtual ...
같은 Main.class를 macOS, Linux, Windows의 JVM에서 그대로 실행할 수 있습니다.
기술 도메인
Kotlin, Scala, Groovy도 JVM 바이트코드로 컴파일되어 Java 라이브러리를 그대로 씀
Spring Boot 앱은 실행 가능한 .jar 하나로 배포하고, Docker 이미지에 JDK/JRE 런타임을 함께 담음
GraalVM Native Image는 미리 네이티브로 컴파일해 시작 시간과 메모리를 줄임 (서버리스에 유리)
메모리와 GC
이론
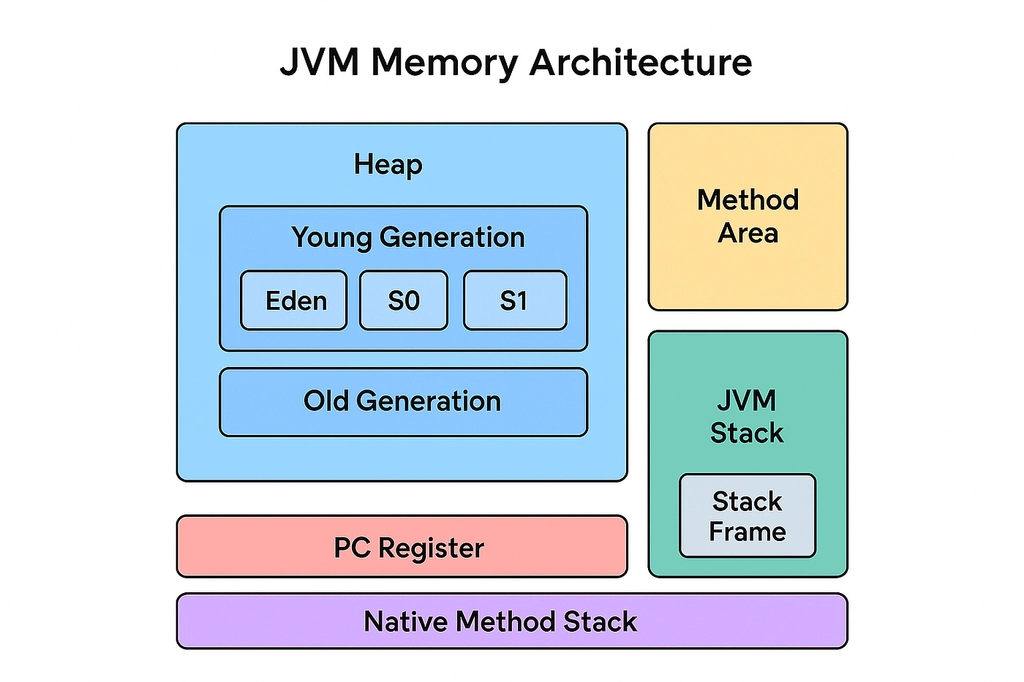
JVM 런타임 데이터 영역:
JVM 메모리 영역
Heap 세대 구조: Young(Eden + Survivor 0/1)과 Old. "대부분의 객체는 금방 죽는다"는 약한 세대 가설에 따라 Young만 자주 청소합니다.
GC 대상 = GC Root(스택의 지역변수, static 변수, JNI 참조 등)에서 참조를 따라가 닿지 않는 객체
Minor GC: Eden이 차면 Young 영역 정리. 살아남은 객체는 Survivor로, 여러 번 살아남으면 Old로 승격(Promotion)
Major GC: Old 영역 정리 / Full GC: Heap 전체(+Metaspace) 정리
GC 중에는 애플리케이션 스레드가 멈추는 Stop-The-World가 발생 → 응답 지연의 원인
보완Java 8부터 클래스 메타데이터 영역이 PermGen에서 네이티브 메모리의 Metaspace로 바뀌었습니다. 승격 기준 나이는 -XX:MaxTenuringThreshold(기본·최대 15)로 정합니다. "Major GC"는 공식 용어가 아니어서 GC 구현마다 의미가 조금씩 다릅니다.
비유
장난감 방 정리
새 장난감은 입구 바구니(Eden)에 넣어요. 바구니가 가득 차면 선생님이 정리해요. 아무도 끈을 잡고 있지 않은 장난감은 치우고, 계속 갖고 노는 장난감은 큰 선반(Old)으로 옮겨요.
정리하는 동안에는 모두 잠깐 "얼음!"이에요(Stop-The-World). 그리고 "절대 버리지 마" 상자(static)에 계속 넣기만 하면 방이 꽉 차 버려요.
입구 바구니→Eden
큰 선반→Old Generation
장난감을 잡은 끈→참조
얼음!→Stop-The-World
방이 꽉 참→OutOfMemoryError
예시
Member m = new Member();   // Eden에 생성, 스택 변수 m이 참조 → 도달 가능
m = null;                  // 참조 끊김 → 도달 불가 → 다음 Minor GC에서 회수

static List<Member> cache = new ArrayList<>();
cache.add(new Member());   // static이 계속 참조 → 회수 안 됨 → 쌓이면 메모리 누수
기술 도메인
운영 옵션 예: java -Xms2g -Xmx2g -XX:+UseG1GC -jar app.jar. OutOfMemoryError가 나면 힙 덤프를 떠서 누수 객체를 추적합니다.
테이블
비교·정리 표
영역
공유
내용
Method Area (Metaspace)
모든 스레드
클래스 정보, static 변수, 상수 풀
Heap
모든 스레드
new로 만든 객체, 배열
JVM Stack
스레드별
메서드 호출 프레임(지역변수, 매개변수)
PC Register
스레드별
현재 실행 중인 명령 위치
Native Method Stack
스레드별
C/C++ 네이티브 메서드 호출
비교·정리 표
GC
특징
Serial / Parallel
단순, 처리량 위주. 소규모·배치
G1
Java 9부터 기본. Heap을 리전으로 나눠 멈춤 시간 목표 관리
ZGC
밀리초 이하 멈춤. Java 21에서 세대별(Generational) 모드 도입
스레드와 스레드 풀
이론
JVM은 프로세스 하나에 스레드 여럿으로 동작합니다.
Java의 기본 스레드(플랫폼 스레드)는 OS 스레드와 1:1로 매핑되고, 스케줄링은 OS가 합니다. 스레드마다 스택 메모리(64비트 Linux 기본 약 1MB)를 잡으므로 생성 비용이 큽니다.
너무 많으면 메모리와 컨텍스트 스위칭 비용이 커져 오히려 느려집니다.
스레드 풀: 스레드를 미리 만들어 두고 작업마다 재사용합니다.
보완Java 21의 가상 스레드는 JVM이 관리하는 경량 스레드로, 소수의 플랫폼 스레드(캐리어) 위에 M:N으로 올라갑니다. 블로킹 I/O를 만나면 캐리어에서 내려오기 때문에, 동기 코드 그대로 높은 동시성을 얻습니다. Java 21에서는 synchronized 안에서 블로킹하면 캐리어에 고정(pinning)되는 문제가 있었고 Java 24(JEP 491)에서 해결되었습니다.
비유
놀이터 그네
친구가 올 때마다 그네를 새로 만들면 너무 오래 걸려요. 그래서 그네 10개를 미리 만들어 두고 차례대로 타요. 이게 스레드 풀이에요.
가상 스레드는 이래요. 그네는 몇 개 없지만, 타던 친구가 신발 끈을 묶느라 멈추면 그 자리에 다른 친구가 바로 타요. 그래서 친구 수만 명도 함께 놀 수 있어요.
그네→플랫폼 스레드
미리 만든 그네들→스레드 풀
신발 끈 묶기→블로킹 I/O
잠깐 비켜 주기→가상 스레드 언마운트
예시
// 고정 크기 스레드 풀: 스레드 10개가 작업 100개를 나눠 처리
ExecutorService pool = Executors.newFixedThreadPool(10);
for (int i = 0; i < 100; i++) {
    int n = i;
    pool.submit(() -> handle(n));
}
pool.shutdown();

// Java 21 가상 스레드: 작업마다 스레드 하나, 수만 개도 가능
try (var ex = Executors.newVirtualThreadPerTaskExecutor()) {
    for (int i = 0; i < 10_000; i++) {
        int n = i;
        ex.submit(() -> handle(n));
    }
}
기술 도메인
Tomcat의 요청 처리 스레드 풀 (기본 최대 200)
같은 원리의 커넥션 풀: HikariCP(Spring Boot 기본, 기본 최대 10개)가 DB 연결을 재사용
Spring Boot 3.2+는 spring.threads.virtual.enabled=true 한 줄로 Tomcat 요청 처리를 가상 스레드로 전환
4. 객체지향 OOP · SOLID
서비스는 반드시 바뀝니다. 캡슐화·상속·다형성·추상화는 OOP의 필수 요소이고, SOLID는 설계 품질을 높이는 선택적 원칙입니다.
절차지향 vs 객체지향
이론
비유
혼자 요리 vs 역할 나눠 요리
절차지향은 한 사람이 레시피 1번부터 끝까지 순서대로 해요. 냉장고 재료를 누구나 꺼내 쓰니까 뭐가 없어졌는지 알기 어려워요.
객체지향은 반죽 친구, 오븐 친구, 장식 친구가 각자 자기 일을 맡고 "반죽 다 됐어?" 하고 서로 부탁해요.
레시피 순서→절차, 함수
역할 맡은 친구→객체
서로 부탁하기→메시지(메서드 호출)
예시
// 절차지향: 데이터(balance)를 여러 함수가 직접 수정
int balance = 10000;
balance = withdraw(balance, 3000);

// 객체지향: 데이터와 규칙을 객체가 함께 가짐
Account account = new Account(10000);
account.withdraw(3000);
기술 도메인
절차지향: C로 짠 임베디드·OS 커널, 짧은 스크립트·배치
객체지향: Java/Spring 엔터프라이즈 백엔드처럼 요구사항이 자주 바뀌고 여러 명이 오래 유지보수하는 코드
테이블
비교·정리 표
구분
절차지향
객체지향
핵심 질문
어떤 작업을 어떤 순서로?
어떤 객체가 어떤 책임을 지고 협력?
구성
함수 중심, 데이터와 기능 분리
객체 = 상태 + 행동, 메시지로 협력
장점
흐름이 단순, 작은 프로그램에 빠름
변경 범위가 좁고 확장에 강함
한계
공유 데이터 변경 추적이 어렵고, 규모가 커지면 복잡도 급증
설계 비용, 과설계 위험
캡슐화 (Encapsulation)
이론
데이터와 그 데이터를 다루는 기능을 묶고, 내부 구현을 숨기는 것. 외부는 객체가 공개한 메서드로만 상호작용하므로 내부가 바뀌어도 영향이 적습니다.
모든 private 필드에 getter/setter를 다는 것은 캡슐화가 아닙니다. 객체가 스스로 책임을 수행하게 만드는 것이 핵심입니다. ("Tell, Don't Ask")
비유
자판기
자판기 문을 열고 음료를 직접 꺼내면 안 돼요. 버튼만 눌러요. 돈이 모자라면 자판기가 알아서 음료를 안 줘요.
안에서 음료를 어떻게 꺼내는지는 몰라도 되고, 자판기 속이 바뀌어도 버튼은 그대로예요.
잠긴 자판기 속→private 필드
버튼→public 메서드
돈이 모자라면 안 줌→규칙(검증)은 객체 안에
예시
public class Account {
    private long balance;

    public void withdraw(long amount) {
        if (amount <= 0) throw new IllegalArgumentException("금액은 0보다 커야 합니다");
        if (balance < amount) throw new IllegalStateException("잔액이 부족합니다");
        balance -= amount;
    }
}
// ❌ account.setBalance(account.getBalance() - 1000);  규칙이 호출부로 새어 나감
// ✅ account.withdraw(1000);                           규칙은 Account 안에
기술 도메인
JPA 엔티티에 setter를 열지 않고 order.cancel() 같은 도메인 메서드로 상태를 바꾸는 관례
API 응답은 엔티티 대신 DTO로 내보내 내부 구조를 숨김
테이블
비교·정리 표
접근 제어자
접근 범위
private
같은 클래스
(default)
같은 패키지
protected
같은 패키지 + 다른 패키지의 자식 클래스
public
어디서나
상속 (Inheritance)
이론
기존 클래스의 상태와 행동을 물려받아 새 클래스를 정의하는 것. "is-a" 관계를 표현하고 다형성의 수단이 됩니다.
부모 구현에 자식이 강하게 결합되어, 부모 변경이 자식을 깨뜨릴 수 있음
Java는 클래스 다중 상속을 지원하지 않음 (인터페이스는 여러 개 구현 가능)
코드 재사용이 목적이면 합성(Composition)이 대개 더 적절 ("has-a")
비유
닮은 가족, 그리고 로봇 팔
펭귄은 새예요. 그래서 "새"가 가진 것(알을 낳아요)을 물려받아도 이상하지 않아요.
하지만 "줄 서기"가 "아무 데나 끼어 앉는 의자 줄"을 물려받으면 새치기가 가능해져요(Stack과 Vector). 그럴 땐 물려받지 말고 가지고 있어요. 로봇이 팔을 "가지고" 있는 것처럼요(합성).
펭귄은 새다→is-a, 상속
로봇이 팔을 가졌다→has-a, 합성
예시
class Member {
    protected String name;
    public void login() { ... }
}
class AdminMember extends Member {       // 관리자는 회원이다 (is-a) → 상속 OK
    public void banUser(Member target) { ... }
}

// 합성: 재사용만 필요하면 필드로 가짐
class OrderService {
    private final DiscountPolicy discountPolicy;   // has-a
}
기술 도메인
실패 사례: JDK의 java.util.Stack은 Vector를 상속해서, 스택인데도 중간 삽입(add(index, e))이 가능해짐. 그래서 지금은 ArrayDeque 사용을 권장
성공 사례: 예외 계층 RuntimeException → IllegalArgumentException처럼 개념적으로 같은 종류일 때
다형성 (Polymorphism)
이론
같은 타입으로 다뤄도 실제 객체에 따라 다른 동작을 하는 것. 핵심은 "구현체를 갈아끼울 수 있다"이며, OCP·DIP로 이어집니다.
비유
"노래해!"
"노래해!"라고 똑같이 말해도 참새는 짹짹, 고양이는 야옹, 강아지는 멍멍 해요. 누가 듣느냐에 따라 다르게 해요. 이게 다형성이에요.
"그려 줘!"에 크레파스를 주면 크레파스 그림, 물감을 주면 물감 그림이 나와요. 무엇을 주는지 보고 미리 정해져요(오버로딩).
"노래해!"→같은 메서드 호출
참새·고양이→서로 다른 구현체
누가 듣는지 보고 결정→런타임 동적 디스패치
예시
interface Payment { void pay(int amount); }
class CardPayment  implements Payment { public void pay(int a) { /* 카드 */ } }
class KakaoPayment implements Payment { public void pay(int a) { /* 카카오 */ } }

class OrderService {
    private final Payment payment;               // 구체 타입을 모름
    OrderService(Payment payment) { this.payment = payment; }
    void order(int amount) { payment.pay(amount); }   // 실제 객체의 pay가 실행
}
기술 도메인
Spring은 같은 인터페이스의 빈들을 Map<String, Payment>로 주입해 줌 → 전략 패턴으로 결제 수단 선택
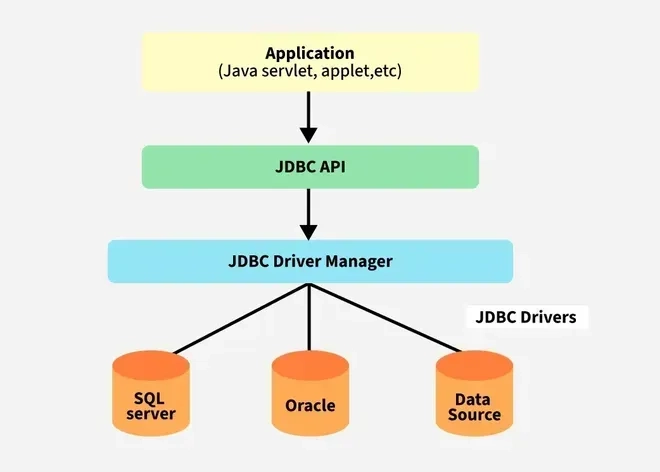
JDBC: 코드는 Connection 인터페이스만 쓰고, 실제 동작은 MySQL/PostgreSQL 드라이버 구현체가 결정
테이블
비교·정리 표
구분
오버라이딩
오버로딩
의미
부모 메서드를 자식이 재정의
같은 이름, 다른 매개변수
결정 시점
런타임 (동적 디스패치)
컴파일 타임
다형성 종류
서브타입 다형성
애드혹(ad-hoc) 다형성
추상화 (Abstraction)
이론
복잡한 세부를 숨기고 필요한 핵심만 드러내는 것. "무엇을 하는가"와 "어떻게 하는가"를 분리합니다.
비유
리모컨
TV 리모컨은 "켜기", "채널 올리기" 버튼만 알면 돼요. 안에 전선이 어떻게 연결됐는지는 몰라도 돼요.
인터페이스는 "이 버튼들이 꼭 있어야 해" 하는 약속 카드예요. 추상 클래스는 몸통은 다 만들어져 있고 얼굴만 직접 그리는 반쯤 만든 인형 키트예요.
버튼→무엇을 하는가(메서드 이름)
안의 전선→어떻게 하는가(구현)
약속 카드→interface
반쯤 만든 키트→abstract class
예시
abstract class Animal {
    protected final String name;              // 공통 상태
    protected Animal(String name) { this.name = name; }
    abstract void sound();                    // 자식마다 다름
    void sleep() { System.out.println(name + " 잠을 잔다"); }   // 공통 구현
}
class Dog extends Animal {
    Dog(String name) { super(name); }
    @Override void sound() { System.out.println("멍멍"); }
}
Spring의 JpaRepository: 인터페이스만 선언하면 구현체는 프레임워크가 만들어 줌
테이블
비교·정리 표
구분
abstract class
interface
목적
공통 상태·구현 공유
역할·규약 정의
개수
하나만 상속
여러 개 구현
필드
인스턴스 필드 가능
상수(public static final)만
생성자
있음
없음
구현 제공
일반 메서드
default·static(Java 8+), private(Java 9+)
SOLID 원칙
이론
DIP의 "역전": 원래 OrderService → MySqlOrderRepository로 향하던 의존이, 구현체가 상위 쪽 인터페이스 OrderRepository를 구현하면서 MySqlOrderRepository → OrderRepository로 방향이 뒤집힙니다.
비유
우리 반 약속 다섯 가지
S: 급식 당번은 급식만, 칠판 당번은 칠판만 해요.
O: 레고 성에 탑을 더 올리고 싶으면 블록을 끼우면 돼요. 성을 부수지 않아요.
L: 술래 대신 들어온 친구가 "난 술래 안 할래" 하면 놀이가 망가져요. 대신 들어오면 같은 약속을 지켜요.
I: 축구하러 갈 땐 축구공만 든 작은 가방을 들어요. 필요 없는 짐까지 다 든 큰 가방은 안 돼요.
D: 선풍기는 벽 속 발전소가 아니라 콘센트 모양에 맞춰요. 그래서 어느 집에 가도 꽂을 수 있어요.
콘센트 모양→인터페이스(추상화)
어느 집 전기든→어떤 구현체든
예시
// SRP: 가입·메일·로그를 각각 분리
class UserService { void register(User u) { ... } }
class EmailSender { void sendWelcome(User u) { ... } }

// OCP: if-else 대신 구현체 추가
// if ("CARD".equals(type)) ... else if ("KAKAO".equals(type)) ...   ❌
class TossPayment implements Payment { ... }                          // ✅

// LSP 위반: 계약(send)을 지키지 못하는 구현체
class KakaoNotification implements Notification {
    public void send(String msg) { throw new UnsupportedOperationException(); }
}

// ISP: 거대한 Worker 대신 역할별 분리
interface Workable   { void work(); }
interface Approvable { void approve(); }

// DIP: 인터페이스에 의존 + 생성자 주입
class OrderService {
    private final OrderRepository repository;
    OrderService(OrderRepository repository) { this.repository = repository; }
}
기술 도메인
SRP: Controller / Service / Repository 계층 분리
OCP: Spring Security 필터 체인에 필터를 추가해 인증 방식을 확장
LSP: List.of(), Collections.unmodifiableList()의 add()는 예외를 던짐. JDK는 이를 "선택적 연산"으로 문서화했지만, 호출부가 수정 가능하다고 가정하면 깨지는 대표 사례
ISP: Spring Data의 Repository → CrudRepository → ListCrudRepository처럼 필요한 만큼만 상속
DIP: Spring IoC 컨테이너가 구현체를 생성자로 주입 (테스트에서는 가짜 구현으로 교체)
테이블
비교·정리 표
원칙
정의
SRP 단일 책임
클래스가 바뀌는 이유는 하나여야 한다
OCP 개방-폐쇄
확장에는 열려 있고, 수정에는 닫혀 있어야 한다
LSP 리스코프 치환
자식 타입은 부모 타입의 계약을 깨지 않고 대체 가능해야 한다
ISP 인터페이스 분리
클라이언트는 쓰지 않는 메서드에 의존하지 않아야 한다
DIP 의존성 역전
상위 정책과 하위 구현 모두 추상화에 의존해야 한다
5. 아키텍처 패턴 ARCHITECTURE
아키텍처는 관심사를 어떻게 나눌지, 의존성을 어느 방향으로 흐르게 할지를 정하는 일입니다.
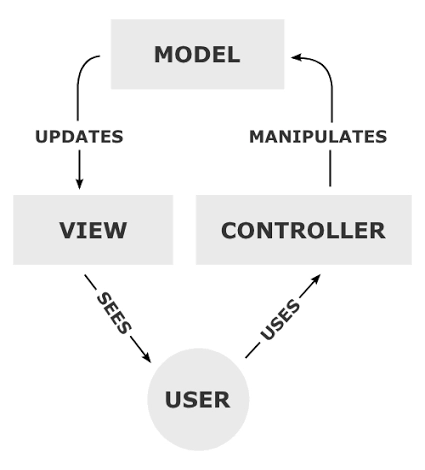
MVC
이론
Model: 데이터와 비즈니스 로직. View와 Controller를 몰라야 함
View: 사용자에게 보여주는 표현. 비즈니스 로직이 없어야 함
Controller: 요청을 받아 Model을 호출하고 응답(View)을 결정. 로직이 들어가면 비대해짐
한계: 큰 틀만 제공하므로, 규모가 커지면 Model 안에 비즈니스 로직과 데이터 접근이 뒤섞입니다. → Layered Architecture
MVC 구조
비유
인형극
이야기와 인형들(Model), 무대와 조명(View), 그리고 "이제 공주가 나올 차례예요!" 하고 둘을 이어 주는 진행자(Controller)가 있어요.
인형은 무대가 어떻게 생겼는지 몰라도 되고, 무대는 이야기를 직접 바꾸지 않아요.
이야기와 인형→Model
무대→View
진행자→Controller
예시
요청 → DispatcherServlet → HandlerMapping → Controller → Model 생성 → ViewResolver → View(Thymeleaf) 렌더링 → 응답
@Controller
public class PostController {
    @GetMapping("/posts/{id}")
    public String detail(@PathVariable Long id, Model model) {
        model.addAttribute("post", postService.find(id));
        return "post/detail";      // templates/post/detail.html
    }
}
기술 도메인
Spring MVC의 @Controller + Thymeleaf (서버 사이드 렌더링)
REST API에서는 @RestController가 View 대신 JSON을 반환. 이때 View 역할은 프론트엔드(React 등)가 맡음
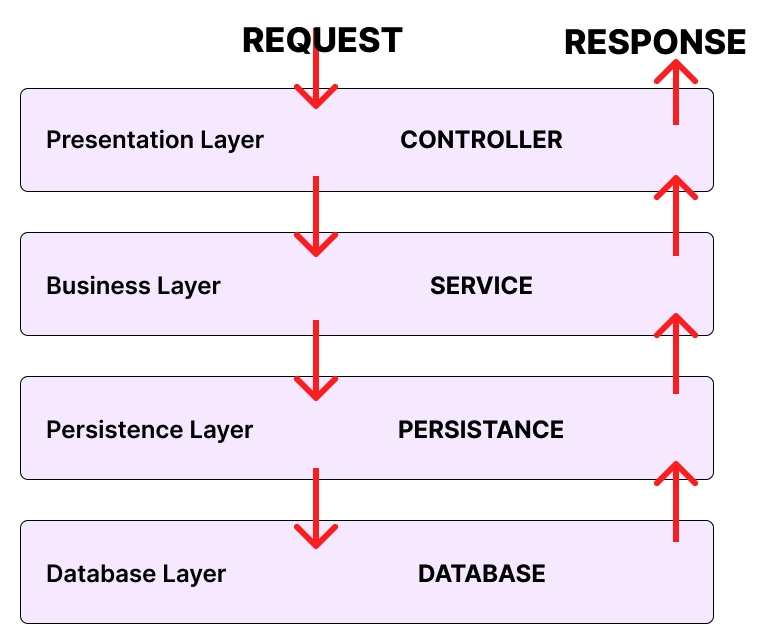
Layered Architecture
이론
역할별 계층으로 나누고, 상위는 하위를 쓸 수 있지만 하위는 상위를 몰라야 합니다.
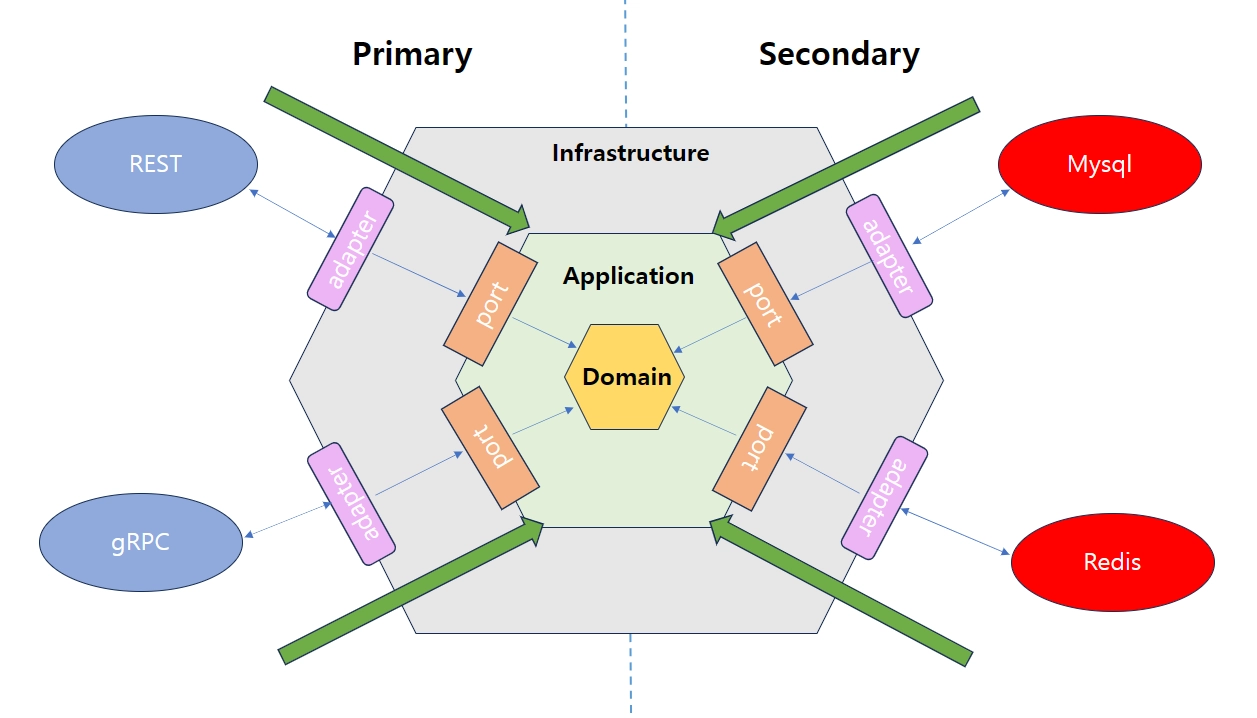
한계: 의존성이 결국 DB 기술을 향합니다. MySQL → MongoDB로 바꾸면 Repository가 제공하던 메서드가 달라져 Service까지 영향을 받을 수 있습니다.
Layered Architecture
비유
3층짜리 식당
1층 홀 직원(Controller)이 주문을 받고, 2층 셰프(Service)가 무엇을 어떻게 요리할지 정하고, 3층 창고지기(Repository)는 재료만 꺼내 줘요.
위층이 아래층에 부탁하지, 창고지기가 손님에게 직접 가지는 않아요. 그런데 창고를 냉장고에서 냉동고로 바꾸면 셰프 요리법까지 바뀔 수 있어요. 이게 Layered의 한계예요.
1차 과제에서 많이 고민했던 세 가지 — 타입 선택, 예외 처리 위치, 로직의 책임 — 를 이번 세미나 내용과 연결해 다시 봅니다.
0-1Primitive vs Wrapper
핵심두 타입의 가장 큰 차이는 null을 허용하느냐입니다. 값이 없을 수도 있으면 Wrapper, 반드시 있으면 Primitive를 고릅니다.
이론
null을 표현할 수 있는가
기본형(int, long, boolean …)은 항상 값이 있어야 하고, 래퍼 타입(Integer, Long, Boolean …)은 “값 없음”을 null로 표현할 수 있습니다. 두 타입 사이에는 자동 박싱·언박싱이 일어납니다.
값이 없다는 것과 0은 다르다
int의 0은 실제 숫자이고 Integer의 null은 “입력하지 않음”입니다. 나이 0세와 나이 미입력을 같은 값으로 처리하면 검색·검증의 의미가 바뀝니다.
주의할 함정 두 가지
래퍼 → 기본형 언박싱 시 값이 null이면 NullPointerException이 발생합니다.
래퍼끼리 ==로 비교하면 값이 아니라 참조를 비교할 수 있으므로 equals 또는 Objects.equals를 씁니다.
Controller 파라미터에서 생기는 문제
required = false이고 defaultValue도 없는 파라미터(= null이 들어올 수 있음)를 기본형으로 받으면 런타임 에러가 납니다.
반대로 필수이거나 기본값이 있어 null이 들어올 일이 없는데 래퍼를 쓰면 의미 없는 null 가능성이 생깁니다.
둘 다 사소해 보이지만, 파라미터마다 “null이 올 수 있나?”를 한 번 짚는 습관이 중요합니다.
비유
신청서의 “나이” 칸에 0을 적는 것과 빈칸으로 두는 것은 다른 의미입니다. 빈칸을 허용하는 신청서라면 “미입력”을 표현할 방법(= null)이 필요합니다.
예시
필수 / 기본값 / 선택 파라미터
@RequestParam("page") int page                              // 필수: 없으면 400
@RequestParam(name = "page", defaultValue = "1") int page   // 기본값: 없으면 1
@RequestParam(name = "category", required = false) Integer category  // 선택: 없으면 null
언박싱 NPE와 값 비교
Integer count = null;
// int value = count;   // 언박싱 시 NullPointerException
boolean same = Objects.equals(Integer.valueOf(1000), Integer.valueOf(1000)); // true
기술 도메인
요청 파라미터 바인딩, 요청·응답 DTO 필드, DB의 nullable 컬럼 매핑에서 같은 고민이 반복됩니다. “이 값은 비어 있을 수 있는가?”를 먼저 정하고 타입을 고릅니다.
테이블
선택·필수·기본값의 실제 차이
선언
누락 시
의미
@RequestParam("page") int page
보통 400
요청 파라미터가 필수
@RequestParam(name="page", defaultValue="1") int page
// Service: 문제가 생긴 곳에서는 던지기만
Post post = repository.findById(id)
    .orElseThrow(() -> new PostNotFoundException(id));

// Web 계층: 한 곳에서 HTTP 응답으로 변환
@RestControllerAdvice
class ApiExceptionHandler {
    @ExceptionHandler(PostNotFoundException.class)
    ResponseEntity<Map<String, String>> notFound(PostNotFoundException e) {
        return ResponseEntity.status(404).body(Map.of(
            "code", "POST_NOT_FOUND", "message", "게시글을 찾을 수 없습니다."));
    }
}
PostNotFoundException은 프로젝트에서 정의한 RuntimeException 하위 타입입니다. 클라이언트에는 내부 스택 트레이스 대신 합의된 오류 코드를 보냅니다.
기술 도메인
Spring에서는 @RestControllerAdvice + @ExceptionHandler로 “예외 → HTTP 응답” 변환을 한 곳에 모읍니다. 검증 로직과 오류 응답 형식을 분리할 수 있습니다.
보완try-catch를 밖으로 옮기는 것 자체가 AOP는 아닙니다. @ExceptionHandler도 엄밀히는 Spring MVC의 예외 처리 메커니즘입니다. 다만 “반복되는 관심사를 분리한다”는 해결 방향이 비슷합니다.
0-3도메인 로직 vs 비즈니스 로직
핵심도메인 로직 = 객체가 스스로 지키는 규칙(예: post.update()). 비즈니스 로직 = 그 도메인 로직들을 조합해 문제를 해결하는 흐름. 다만 조직마다 두 용어를 섞어 쓰기도 합니다.
이론
왜 헷갈릴까?
MVC에서는 Model이 핵심 로직을, Controller가 흐름을 담당한다고 했습니다. 그런데 Controller가 커지면서 레이어드 아키텍처의 business(Service) 계층이 생겼고, 그 계층이 “비즈니스 로직”을 맡는다고 말합니다. 그래서 “핵심 로직 = 비즈니스 로직 아닌가?”라는 의문이 생깁니다.
세미나의 구분: 핵심(도메인) 로직 ≠ 비즈니스 로직
도메인 로직: 도메인 객체가 가지는 역할과 책임입니다. 게시글의 update, updateTitle, updateContent 등.
비즈니스 로직: 비즈니스 문제를 해결하기 위한 도메인 로직의 조합과 흐름입니다. 도메인 로직은 이 흐름의 적절한 위치에서 호출됩니다.
정답은 “해석에 따라 다르다”
두 용어는 실무에서 자주 혼용됩니다. 도메인 객체가 값만 담고 로직이 없는 단순한 프로젝트라면 구분 자체가 의미 없을 수도 있습니다. 공부하는 입장에서는 엄밀하게 나눠 생각해 보는 것이 설계 감각에 도움이 됩니다.
비유
요리법의 규칙(“계란은 반드시 익힌다”)은 도메인 로직, 주문 하나를 처리하는 순서(주문 확인 → 재료 확인 → 조리 → 포장)는 비즈니스 로직입니다.
예시
“게시글 수정”이라는 비즈니스 로직의 흐름
게시글 조회수정 요청이 온 게시글이 실제로 존재하는지 확인
권한 확인요청한 사용자가 수정 권한이 있는 사람인지 확인
내용 수정 — 도메인 로직post.update(title, content) 호출, 제목 검증 등 규칙은 Post가 지킴
저장수정된 게시글을 저장소에 반영
코드로 나누면
// Service: 비즈니스 흐름 조율
public void updatePost(long id, long memberId, String title, String content) {
    Post post = repository.findById(id).orElseThrow();
    if (!post.isWrittenBy(memberId)) throw new ForbiddenException();
    post.update(title, content);   // ← 도메인 로직 호출
    repository.save(post);
}

// Post: 도메인 규칙
public void update(String title, String content) {
    if (title == null || title.isBlank()) {
        throw new IllegalArgumentException("제목은 비어 있을 수 없습니다.");
    }
    this.title = title;
    this.content = content;
}
기술 도메인
Controller는 HTTP 연결, Service는 유스케이스 흐름 조율, Domain은 규칙, Repository는 저장을 맡습니다. 제목 검증을 생성·수정에 각각 중복하지 않도록 도메인의 공통 메서드로 묶을 수 있고, 권한 정책의 위치는 프로젝트 설계에 따라 달라집니다.
테이블
Controller가 커질 때 분리할 기준
계층
주요 책임
게시글 수정 예시
Controller
HTTP 요청·응답 연결
경로 ID, JSON DTO를 받고 Service 호출
Service
유스케이스 수행 순서
조회, 정책 확인, 변경, 저장
Domain
객체 상태와 규칙
제목 검증 및 내용 변경
Repository
저장과 조회
ID로 조회하고 변경 결과 저장
보완“비즈니스 로직”은 도메인 규칙까지 포함하는 넓은 의미로도 널리 쓰입니다. “도메인 로직 ≠ 비즈니스 로직”은 보편적 정의가 아니라 책임을 나눠 생각하기 위한 관점으로 받아들이면 됩니다.
01HTTP
1차 세미나의 클라이언트-서버 구조에서 “요청과 응답”에도 규칙이 있다고 했습니다. 그중 우리가 가장 많이 쓰는 규칙이 HTTP입니다.
1-1HTTP란? 4가지 특징
핵심HTTP는 클라이언트와 서버가 데이터를 주고받는 애플리케이션 계층의 통신 규약입니다. 요청은 항상 클라이언트가 시작하고, 서버는 이전 요청을 기억하지 않습니다(무상태).
이론
HTTP(HyperText Transfer Protocol)
처음에는 HTML 같은 하이퍼텍스트 문서를 보내려고 만들어졌지만, 바이트 데이터라면 무엇이든 보낼 수 있어서 지금은 이미지·영상·JSON 등 거의 모든 데이터를 HTTP로 주고받습니다.
① 클라이언트-서버 구조 (Request-Response)
역할에 따라 클라이언트(브라우저, 앱, 임베디드 프로그램 등)와 서버로 나뉩니다. 클라이언트가 요청을 보내고 서버가 응답합니다. 대화의 시작은 언제나 클라이언트입니다.
② 무상태 (Stateless)
서버는 이전 요청을 기억하지 않고 모든 요청을 독립적으로 처리합니다.
장점 어떤 서버가 응답해도 되므로 서버를 수평 확장(Scale-out)하기 쉽습니다.
단점 요청마다 필요한 정보를 모두 담아야 하므로 보내는 데이터가 커집니다.
무상태는 “DB에 아무것도 저장하지 않는다”는 뜻이 아닙니다. 게시글·회원 같은 자원은 저장합니다. 요청 해석이 이전 요청의 맥락에 의존하지 않는다는 점이 핵심입니다.
③ 비연결성 (Connectionless)
기본적으로 응답 후 연결을 끊어, 수많은 클라이언트와 연결을 유지하느라 서버 자원을 낭비하지 않습니다. 다만 매번 TCP 연결(3-way handshake)을 새로 맺는 비용이 크기 때문에 HTTP/1.1부터는 Keep-Alive(지속 연결)로 연결을 재사용합니다.
Q. 연결을 유지하는데 왜 비연결성인가요? 유지되는 것은 전송 계층의 TCP 연결이지 HTTP 통신 단위가 아니기 때문입니다. HTTP는 요청-응답이 끝나면 그 대화가 끝나고, 연결의 생성·해제 과정도 여전히 존재합니다.
④ 텍스트 기반 · 확장 가능
HTTP/1.1 메시지는 사람이 읽을 수 있는 텍스트이고, 헤더를 추가해 기능을 확장합니다. 리다이렉션의 Location, 캐시 정책의 Cache-Control처럼 데이터 전달 외의 기능을 붙일 수 있습니다.
비유
배달 앱에 주문할 때마다 메뉴와 배송 주소를 매번 적는 것과 같습니다. 가게는 “지난번 그 손님”을 기억하지 않으니, 어느 지점(서버)이 주문을 받아도 똑같이 처리할 수 있습니다.
예시
무상태가 확장에 유리한 이유
서버 A가 직전 요청의 로그인 상태를 자기 메모리에만 보관하면, 다음 요청을 서버 B가 받았을 때 같은 사용자인지 판단할 수 없습니다. 각 요청에 인증 정보(세션 ID, 토큰)를 함께 보내고 공통 검증 규칙을 쓰면 A와 B가 똑같이 처리할 수 있습니다.
기술 도메인
로드밸런서 뒤에 여러 서버를 두는 구조는 무상태 요청을 전제로 할 때 가장 단순해집니다. 대신 로그인 같은 “상태”는 토큰이나 공유 세션 저장소처럼 애플리케이션 차원에서 따로 설계해야 합니다.
테이블
HTTP 버전과 연결을 구분하기
구분
연결·메시지 관점
주의점
HTTP/1.0
전형적으로 요청마다 새 연결
지속 연결 확장이 사용되기도 함
HTTP/1.1
지속 연결이 기본
응답 종료 ≠ TCP 종료
HTTP/2
하나의 연결에서 여러 스트림 다중화
바이너리 프레임으로 메시지 전송
HTTP/3
QUIC 기반 스트림
TCP 3-way handshake 설명을 그대로 적용하면 안 됨
보완HTTP/1.1은 지속 연결이 기본값이므로 “요청마다 연결을 끊는다”는 설명은 HTTP/1.0 기준입니다. 또 HTTP/2는 바이너리 프레이밍, HTTP/3은 QUIC(UDP 기반)을 쓰므로 “HTTP = 텍스트 · TCP · 비연결”로 일반화하지 않습니다.
1-2URL 읽는 법
핵심URL은 자원이 어디에 있는지를 알려 주는 주소입니다. scheme://host:port/path?query 다섯 조각으로 나눠 읽습니다.
이론
URL(Uniform Resource Locator)
자원을 위치로 식별하는 방법으로, URI의 한 종류입니다. 클라이언트가 서버의 자원을 요청하려면 그 자원이 어디 있는지 알려 줘야 합니다.
경로(path)와 쿼리(query)는 역할이 다르다
/posts/42는 특정 게시글을 식별하고, /posts?page=2&keyword=spring은 목록에 적용할 조건을 표현합니다.
알아 두면 좋은 디테일
#section 같은 fragment는 브라우저 안에서만 쓰이고 서버로 보내는 요청에는 포함되지 않습니다.
https://api.sopt.org:443/posts/42?preview=true#comments

GET /posts/42?preview=true HTTP/1.1
Host: api.sopt.org
// #comments는 요청에 포함되지 않습니다.
기술 도메인
http의 기본 포트는 80, https는 443이라 생략할 수 있습니다. 서버는 어떤 경로를 같은 자원으로 볼지, 어떤 쿼리를 필터로 받을지를 API 계약에 정해야 합니다.
테이블
URL 구성요소
구성요소
의미
scheme
사용할 프로토콜 (http, https)
host
서버의 도메인 또는 IP
port
서버 프로그램의 포트 (http 80, https 443은 생략 가능)
path
서버 안에서 자원의 경로
query
key=value 형태의 추가 정보, &로 연결
1-3HTTP 메시지 구조
핵심요청과 응답은 같은 뼈대를 가집니다. 시작 줄 → 헤더 → 빈 줄 → 바디 순서입니다.
이론
HTTP 메시지
HTTP로 주고받는 데이터 덩어리를 HTTP 메시지라고 합니다.
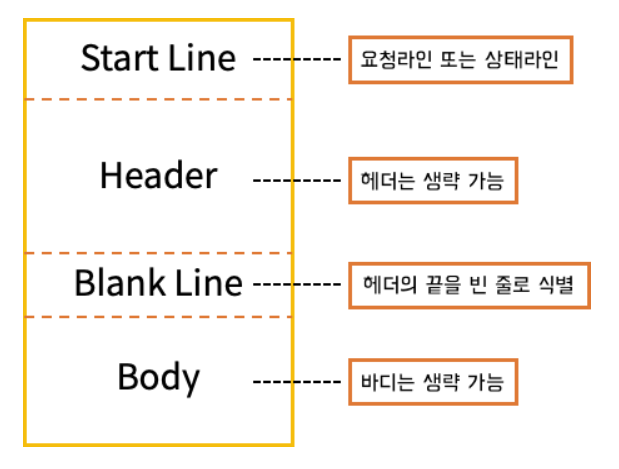
시작 줄: 요청이면 메서드 + 경로 + 버전, 응답이면 버전 + 상태 코드 + 설명
헤더: 메시지에 대한 부가 정보 (Key: Value)
빈 줄: 헤더가 끝났다는 표시
바디: 실제 데이터 (없어도 됨)
읽는 순서
시작 줄에서 무엇을 어디에 하려는지 보고, 헤더에서 인증·형식을 확인한 뒤, 빈 줄 이후 바디를 해석합니다. 응답도 상태 코드로 큰 결과를 먼저 알리고 헤더·바디로 상세 정보를 전달합니다. 204 응답처럼 바디가 없는 응답도 유효합니다.
HTTP 메시지 구조
비유
편지 봉투(시작 줄 + 헤더)에는 받는 곳과 배송 정보가, 봉투 안(바디)에는 실제 내용이 있습니다.
예시
요청 메시지 (Request)
POST /posts HTTP/1.1          ← 요청 줄
Host: api.sopt.org            ← 헤더
Content-Type: application/json
Authorization: Bearer eyJhbGci...
                              ← 빈 줄
{                             ← 바디
  "title": "2차 세미나 후기",
  "content": "REST가 뭔지 알게 됐다!"
}
응답 메시지 (Response)
HTTP/1.1 201 Created          ← 상태 줄
Content-Type: application/json ← 헤더
Location: /posts/42
                              ← 빈 줄
{                             ← 바디
  "id": 42,
  "title": "2차 세미나 후기",
  "content": "REST가 뭔지 알게 됐다!"
}
기술 도메인
Spring MVC는 요청 줄·헤더·바디를 읽어 Controller 파라미터로 바꿔 주고(→ 6-2), Controller의 반환 값을 상태 줄·헤더·바디로 다시 써 줍니다(→ 6-3).
1-4메서드 · 안전 · 멱등
핵심메서드는 자원에 대해 무엇을 하고 싶은지를 나타냅니다. 멱등한 요청(GET·PUT·DELETE)은 여러 번 보내도 결과가 같아서 안심하고 재시도할 수 있습니다.
이론
HTTP 메서드
요청 줄의 첫 단어로, GET 조회 · POST 생성/처리 · PUT 전체 대체 · PATCH 일부 수정 · DELETE 삭제를 뜻합니다. 요청이 기대하는 행위를 표현하므로 알맞은 메서드를 고르는 것이 중요합니다. 이외에도 OPTIONS, HEAD, TRACE, CONNECT가 표준 메서드입니다.
안전(Safe)
호출해도 자원이 변경되지 않는 메서드입니다. GET, HEAD, OPTIONS(, TRACE)가 해당합니다.
멱등(Idempotent)
한 번 호출하든 여러 번 호출하든 서버 상태가 같은 메서드입니다. 안전한 메서드 + PUT, DELETE가 해당합니다.
DELETE /posts/1을 10번 보내도 1번 게시글이 삭제된 상태는 같습니다 → 멱등
POST /posts를 10번 보내면 게시글이 10개 생깁니다 → 멱등 아님
PATCH는 구현에 따라 다릅니다. “좋아요 1 증가” 같은 요청은 멱등이 아닙니다.
왜 중요할까?
네트워크 오류로 응답을 못 받았을 때 멱등한 요청은 안심하고 재시도할 수 있습니다. 결제 요청(POST)을 무심코 재시도하면 중복 결제가 일어날 수 있습니다.
비유
에어컨을 “20도로 설정”(PUT)하는 버튼은 몇 번 눌러도 20도지만, “1도 올리기”(POST/PATCH) 버튼은 누를수록 온도가 달라집니다.
예시
멱등성을 서버 상태로 비교하기
✓ 멱등: 반복해도 최종 상태 동일
PUT /posts/42
{"title":"새 제목","content":"새 본문"}
// 1회든 3회든 같은 상태
✗ 멱등 아님: 반복할수록 달라짐
PATCH /posts/42
{"increment": 1}
// 증가 연산이라면 매번 상태가 바뀜
멱등성은 응답이 매번 같다는 뜻이 아닙니다. DELETE를 두 번 보내면 첫 응답은 204, 두 번째는 404일 수 있지만 “삭제된 상태”라는 서버 효과는 같으므로 멱등입니다.
기술 도메인
재시도 설계
응답이 유실되면 호출자는 서버가 작업을 수행했는지 확신할 수 없습니다. 결제·주문 같은 POST에는 요청 식별자(Idempotency Key)를 함께 보내고 서버에서 중복 처리를 막는 정책을 둘 수 있습니다.
테이블
HTTP 메서드 한눈에 보기
메서드
의미
바디
예시
GET
자원 조회
보통 없음 (쿼리 파라미터 사용)
게시글 목록 조회
POST
자원 생성, 처리 요청
있음
게시글 작성
PUT
자원 전체 대체 (없으면 생성)
있음
게시글 전체 수정
PATCH
자원 일부 수정
있음
게시글 제목만 수정
DELETE
자원 삭제
보통 없음
게시글 삭제
CRUD와 메서드의 의미
메서드
의도
본문
대표 경로
GET
표현 조회
일반적으로 사용하지 않음
/posts?page=1
POST
자원별 의미에 따른 처리; 생성에 자주 사용
처리할 데이터
/posts
PUT
대상 자원 상태를 요청 표현으로 대체
대체할 표현
/posts/42
PATCH
부분 변경 적용
변경 명세
/posts/42
DELETE
대상 URI와 자원의 연결 제거
일반적으로 사용하지 않음
/posts/42
메서드의 속성 — 안전과 멱등
속성
의미
해당 메서드
안전(Safe)
호출해도 자원이 변경되지 않음
GET, HEAD, OPTIONS, TRACE
멱등(Idempotent)
한 번 호출하든 여러 번 호출하든 결과(서버 상태)가 같음
GET, PUT, DELETE (+ HEAD, OPTIONS, TRACE)
보장 안 됨
반복 시 상태가 달라질 수 있음
POST, PATCH (구현에 따라)
그 밖의 표준 메서드
메서드
역할
HEAD
GET과 같은 대상의 메타데이터를 조회하되 응답 본문은 없음
OPTIONS
대상에서 가능한 통신 옵션 확인; CORS preflight에도 사용
TRACE
요청 경로 진단용 루프백; 보안상 비활성화되는 경우가 많음
CONNECT
프록시를 통해 터널 설정
보완원문의 {"likes": +1}은 유효한 JSON이 아닙니다. 증가 의도를 표현하려면 {"increment": 1} 같은 계약이 필요합니다. 또 PUT이 “없으면 생성”까지 허용할지는 API 계약으로 정하고, 로그 기록 같은 부수 효과는 안전성 정의와 별개입니다.
1-5상태 코드
핵심응답의 세 자리 숫자로 결과를 알립니다. 2xx 성공 · 3xx 이동 · 4xx 클라이언트 잘못 · 5xx 서버 잘못. 오류를 200으로 감추지 않습니다.
이론
첫 자리만 봐도 결과를 안다
상태 코드는 클라이언트·프록시·모니터링 도구가 바디를 열어 보지 않고도 결과를 판단하게 해 주는 약속입니다.
4xx와 5xx의 차이
4xx는 클라이언트의 요청이 잘못된 것이라 같은 요청을 다시 보내도 대개 실패합니다. 5xx는 서버 쪽 문제라 잠시 후 재시도하면 성공할 수도 있습니다.
3xx와 Location
301·302 응답은 보통 헤더 Location에 이동한 자원의 위치를 함께 보내고, 브라우저가 자동으로 그곳으로 이동합니다.
⚠️ 모든 응답을 200 + "success": false로 보내지 않기
모니터링·캐시·클라이언트의 공통 오류 처리가 실제 실패를 인식하지 못하게 됩니다.
비유
택배 조회의 배송 완료(2xx) · 주소 이전(3xx) · 주소 오류(4xx) · 물류센터 장애(5xx)와 같습니다. 주소 오류는 다시 보내도 실패하지만, 물류센터 장애는 기다리면 해결될 수 있습니다.
예시
게시판에서 어떤 코드를 쓸까?
POST   /posts         → 201 Created  + Location: /posts/42
GET    /posts/42      → 200 OK
DELETE /posts/42      → 204 No Content (바디 없음)
GET    /posts/999     → 404 Not Found
POST   /posts {제목 없음} → 400 Bad Request
로그인 안 하고 작성     → 401 Unauthorized
남의 글 삭제 시도       → 403 Forbidden
PATCH  /posts (미지원)   → 405 Method Not Allowed
처리 못 한 예외         → 500 Internal Server Error
기술 도메인
코드에 따라 클라이언트의 후속 처리가 달라진다
401이면 재로그인, 403이면 권한 안내, 404면 “없는 게시글” 화면, 409면 충돌 해결을 안내합니다. 503에는 Retry-After를 줄 수 있습니다. 재시도는 메서드의 멱등성과 간격까지 함께 고려합니다.
301·302는 일부 클라이언트가 POST를 GET으로 바꿀 수 있으므로, 메서드를 유지해야 하면 307·308을 검토합니다.
테이블
상태 코드 범위
범위
분류
의미
1xx
Informational
요청을 받았고 처리 중 (거의 안 씀)
2xx
Success
요청 성공
3xx
Redirection
다른 곳으로 가서 요청을 완료하라
4xx
Client Error
클라이언트가 잘못함 — 같은 요청을 다시 보내도 실패
5xx
Server Error
서버가 잘못함 — 재시도하면 성공할 수도 있음
자주 쓰는 상태 코드
코드
이름
게시판 또는 인프라 예시
200
OK
목록·단건 조회 또는 본문 있는 수정 성공
201
Created
새 게시글 생성; Location으로 URI 전달 가능
204
No Content
삭제 성공; 응답 본문 없음
301
Moved Permanently
영구 이동 위치를 Location으로 전달
302
Found
일시적인 다른 위치로 이동
400
Bad Request
잘못된 JSON, 타입 변환 실패, 입력 검증 실패
401
Unauthorized
유효한 인증 자격 증명 없음; 인증 챌린지와 관련
403
Forbidden
요청은 이해했지만 수행을 거부
404
Not Found
대상 자원이 없거나 존재를 공개하지 않음
405
Method Not Allowed
해당 자원에서 메서드 미지원; Allow 헤더 제공
409
Conflict
현재 자원 상태와 충돌; 중복 또는 버전 충돌
500
Internal Server Error
처리되지 않은 예외 등 서버 내부 문제
502
Bad Gateway
중간 서버가 상위 서버에서 유효하지 않은 응답을 받음
503
Service Unavailable
과부하·점검 등으로 일시적 제공 불가
보완4xx라고 모두 재시도가 무의미한 것은 아닙니다. 408(시간 초과), 429(요청 과다)는 상황이 바뀌면 성공할 수 있습니다. 502는 “서버가 프록시와 연결되지 않은 상태”라기보다 게이트웨이·프록시가 상위 서버로부터 유효하지 않은 응답을 받은 경우입니다.
1-6HTTP 헤더
핵심헤더는 메시지에 대한 부가 정보(메타데이터)입니다. 특히 Content-Type(내가 보내는 형식)과 Accept(내가 받고 싶은 형식)를 구분합니다.
이론
Key: Value
헤더는 Key: Value 형태로 바디의 형식·크기, 인증 정보, 캐시 정책, 쿠키 등 데이터 외의 정보를 담습니다.
방향을 함께 기억하기
Host·Accept·Authorization은 요청에, Location·Set-Cookie는 응답에, Content-Type·Cache-Control은 양쪽에 쓰입니다.
비유
택배 송장의 “취급 주의 · 냉장 · 받는 사람 · 무게” 표시와 같습니다. 상자 안 물건(바디)을 열어 보지 않아도 어떻게 다뤄야 할지 알 수 있습니다.
예시
Content-Type과 Accept
POST /posts HTTP/1.1
Host: api.sopt.org
Content-Type: application/json   // 내가 보내는 바디는 JSON
Accept: application/json         // 응답도 JSON으로 받고 싶음
Authorization: Bearer access-token

{"title":"2차 세미나 후기","content":"HTTP 학습"}
서버가 지원하지 않는 요청 본문 형식이면 415, 제공할 수 없는 응답 형식을 요구하면 406이 될 수 있습니다.
기술 도메인
Spring의 @RequestHeader로 헤더 값을 받을 수 있고, @RequestBody 변환은 Content-Type을 보고 알맞은 HttpMessageConverter를 고릅니다. Content-Length는 바이트 길이이며 항상 필요한 것은 아닙니다.
테이블
자주 쓰는 헤더
헤더
방향
의미
Host
요청
요청하는 서버의 도메인 (필수)
Content-Type
양쪽
바디의 데이터 형식 (application/json, multipart/form-data)
Content-Length
양쪽
바디의 크기
Accept
요청
클라이언트가 받고 싶은 응답 형식
Authorization
요청
인증 정보 (Bearer {토큰})
Cookie / Set-Cookie
요청 / 응답
쿠키 전송 / 쿠키 저장 지시
Location
응답
새로 생성된 자원 또는 리다이렉트할 위치
Cache-Control
양쪽
캐시 정책
자주 사용하는 헤더 전체 비교
헤더
방향
읽는 방법
Host
요청
HTTP/1.1에서 대상 호스트 식별
Content-Type
요청·응답
현재 본문의 미디어 타입
Content-Length
요청·응답
본문 길이(바이트); 항상 필요한 것은 아님
Accept
요청
클라이언트가 수용할 응답 미디어 타입
Authorization
요청
Bearer 토큰 등 인증 자격 증명
Cookie / Set-Cookie
요청 / 응답
저장된 쿠키 전송 / 브라우저에 저장 지시
Location
응답
생성 자원의 URI 또는 이동 위치
Cache-Control
요청·응답
저장·재사용과 검증 정책
1-7무상태 HTTP에서 사용자를 기억하는 방법
핵심서버가 기억하지 못하니 매 요청마다 “내가 누구인지” 증명할 정보를 함께 보냅니다. 쿠키·세션·토큰(JWT)이 그 방법입니다.
이론
로그인 상태는 어떻게 유지될까?
HTTP는 무상태라 서버는 방금 로그인한 사용자를 기억하지 못합니다. 그래도 한 번 로그인하면 계속 로그인 상태로 쓸 수 있는 이유는, 클라이언트가 매 요청마다 증명 정보를 같이 보내기 때문입니다.
세 가지 방식
쿠키: 서버가 Set-Cookie로 저장시키면 브라우저가 이후 요청마다 자동으로 보냅니다.
쿠키는 저장·전송 수단, 세션은 서버의 상태 관리 방식, JWT는 토큰 형식입니다. 그래서 “세션 ID를 쿠키에 담는” 식으로 함께 쓰입니다.
비유
쿠키는 지갑, 세션 ID는 사물함 번호표(물건은 가게에 보관), JWT는 위조 방지 도장이 찍힌 출입증(정보가 출입증에 적혀 있음)입니다.
예시
세션 ID의 왕복과 JWT 요청
// 세션 방식: 로그인 응답
HTTP/1.1 200 OK
Set-Cookie: SID=random-session-id; Path=/; HttpOnly; Secure; SameSite=Lax

// 이후 요청: 브라우저가 자동으로 쿠키 전송
GET /members/me HTTP/1.1
Cookie: SID=random-session-id

// JWT 방식: 클라이언트가 직접 헤더 구성
GET /members/me HTTP/1.1
Authorization: Bearer signed-access-token
모바일 앱과 협업하는 서버는 주로 토큰 방식을 씁니다. 세션은 여러 서버 간 세션 공유, JWT는 짧은 유효 기간과 재발급·폐기 설계를 함께 고민해야 합니다. 자세한 내용은 이후 인증/인가 세미나에서 다룹니다.
테이블
쿠키 · 세션 · 토큰 비교
방식
동작
상태 저장 위치
특징
쿠키
서버가 Set-Cookie로 저장시키면, 브라우저가 이후 요청마다 자동으로 전송
클라이언트
탈취·위변조 위험, 민감 정보 저장 금지
세션
서버가 사용자 정보를 저장하고, 클라이언트에는 세션 ID만 쿠키로 전달
서버
안전하지만 서버가 상태를 가짐 → 확장 시 세션 공유 문제
토큰 (JWT)
서버가 서명한 토큰을 발급, 클라이언트가 Authorization 헤더로 전송
클라이언트
서버가 상태를 갖지 않아 확장에 유리, 발급 후 강제 만료가 어려움
로그인 요청 다음에는 무엇을 보내나요?
방식
로그인 때
다음 요청 때
서버가 확인할 것
세션 + 쿠키
서버 세션 생성 후 세션 ID를 Set-Cookie로 전달
브라우저가 Cookie에 세션 ID 전송
세션 저장소에서 사용자·만료 조회
JWT Bearer
서명된 토큰 발급
클라이언트가 Authorization 헤더 구성
서명, 만료, 발급자·대상 등 검증
보완JWT는 일반적으로 암호화가 아니라 서명됩니다. 누구나 내용을 읽을 수 있으므로 비밀 정보를 넣지 않습니다. JWT도 쿠키에 담을 수 있고, 서버가 폐기 목록을 유지하는 설계도 가능합니다.
02API
HTTP는 “어디로 무엇을 요청하는지”의 규칙일 뿐, 구체적으로 어떤 데이터를 주고받을지는 정해 주지 않습니다. 그 약속이 API입니다.
2-1인터페이스와 API
핵심인터페이스는 “어떻게 쓰는지”만 알면 “어떻게 동작하는지”는 몰라도 되게 하는 약속입니다. API는 프로그램끼리 맺는 그 약속이고, 서버 개발자가 만드는 것은 그중 Web API입니다.
이론
인터페이스(Interface)
1차 세미나의 Payment 인터페이스를 떠올려 봅시다. OrderService는 내부가 카드 결제인지 카카오 결제인지 몰라도 pay()를 호출하는 방법만 알면 결제할 수 있었습니다. 서로 다른 두 대상이 소통하기 위한 약속이 인터페이스입니다.
API(Application Programming Interface)
프로그램과 프로그램이 서로 기능과 데이터를 주고받기 위해 정해 둔 약속(규격)입니다. 생각보다 넓은 의미로 쓰여서 Java의 List.add()도, 운영체제의 파일 읽기도 API입니다.
서버는 약속 하나로 모든 클라이언트를 상대한다
서버는 Web API 하나만 잘 만들어 두면 iOS·Android·Web 어떤 클라이언트든 그 약속만 지키면 사용할 수 있습니다. HTTP가 메서드·상태 코드의 공통 의미를 정해도, title 필드가 필수인지, 최대 길이가 얼마인지, 누락 시 무엇을 반환할지는 API에서 정해야 합니다.
비유
식당 메뉴판: 메뉴를 고르면 음식이 나온다는 것만 알면 되고, 주방의 레시피와 조리 과정은 몰라도 됩니다. 메뉴판이 API, 주방이 서버 내부 구현입니다.
예시
interface Payment {
    void pay(int amount);   // 쓰는 쪽은 이 약속만 안다
}
게시글 생성 API 계약
아래 표(테이블)처럼 메서드·경로·요청·검증·성공·실패를 문서로 합의해 두면 Web·iOS·Android가 같은 API를 사용할 수 있습니다. 필드 이름이나 타입을 바꿀 때도 기존 호출자에 미칠 영향을 계약 단위로 검토합니다.
기술 도메인
API 문서에는 경로 · 메서드 · 헤더 · 요청 필드 · 상태 코드 · 응답 필드 · 오류 형식을 합의합니다. 실무에서는 Swagger(OpenAPI), Postman 컬렉션 등으로 공유합니다.
테이블
일상 속 인터페이스
인터페이스
사용자가 아는 것
사용자가 몰라도 되는 것
자판기 버튼
버튼을 누르면 음료가 나온다
내부 기계 장치, 재고 관리 방식
콘센트
플러그를 꽂으면 전기가 들어온다
발전소, 송전망
식당 메뉴판
메뉴를 고르면 음식이 나온다
주방의 레시피, 조리 과정
API의 종류
종류
설명
예시
라이브러리/언어 API
프로그래밍 언어나 라이브러리가 제공하는 기능
List.add(), String.length() (Java API)
OS API
운영체제가 프로그램에게 제공하는 기능
파일 읽기/쓰기, 스레드 생성 (시스템 콜)
Web API
네트워크(HTTP)를 통해 다른 서버의 기능을 사용
카카오 로그인, 토스 결제, 공공데이터 API
게시글 생성 API 계약 예시
항목
합의 내용
메서드·경로
POST /api/v1/posts
인증
Authorization: Bearer 토큰 (인증 도입 시)
요청
application/json; title, content 문자열
검증
title은 공백 불가; 길이 제한은 프로젝트 규칙으로 명시
성공
201 Created + Location + 생성된 게시글 표현
실패
400 입력 오류, 401 인증 실패 등의 코드·응답 형식
2-2Web API의 통신 방식
핵심Web API를 설계하는 방식에는 REST · SOAP · GraphQL · gRPC가 있고, 대부분의 웹/앱 서비스는 REST를 씁니다. 우리가 앞으로 구현할 것도 REST입니다.
이론
네 가지 방식은 종류가 조금씩 다르다
REST: HTTP를 그대로 활용하는 자원 중심의 아키텍처 스타일
SOAP: XML 기반의 엄격한 메시징 규약 (WSDL 명세)
GraphQL: 클라이언트가 필요한 필드를 고르는 쿼리 언어와 실행 모델
gRPC: HTTP/2 + Protocol Buffers 기반의 RPC 프레임워크
REST를 이해하려면 HTTP부터
REST는 “HTTP를 잘 쓰자”는 약속이기 때문에 앞에서 HTTP를 먼저 배웠습니다.
비유
REST는 정해진 메뉴 주문, SOAP는 도장까지 찍는 엄격한 주문서, GraphQL은 필요한 재료만 골라 담는 샐러드 바, gRPC는 주방 직원끼리의 빠른 내선 전화입니다.
예시
같은 게시글을 요청하는 서로 다른 방식
REST: URI로 대상을 표현
GET /posts/42
GraphQL: 필요한 필드를 쿼리로 선택
query {
  post(id: "42") {
    id
    title
  }
}
어느 방식이든 인증·검증·오류 처리 계약은 따로 필요합니다.
기술 도메인
gRPC는 보통 HTTP/2와 Protocol Buffers(바이너리)를 써서 서버 ↔ 서버(마이크로서비스) 통신에 많이 쓰이고, SOAP는 금융권·레거시 기업 시스템에서 WSDL 계약과 함께 쓰입니다.
테이블
Web API 방식 한눈에 보기
방식
특징
주 사용처
REST
HTTP를 그대로 활용, 자원 중심, 주로 JSON
대부분의 웹/앱 서비스
SOAP
XML 기반, 엄격한 규격과 명세(WSDL)
금융권, 레거시 기업 시스템
GraphQL
클라이언트가 필요한 데이터를 쿼리로 골라서 요청
화면마다 필요한 데이터가 다양한 서비스
gRPC
HTTP/2 + Protocol Buffers(바이너리), 매우 빠름
서버 ↔ 서버(마이크로서비스) 간 통신
REST·SOAP·GraphQL·gRPC를 구체적으로 비교하기
방식
계약과 메시지
장점이 드러나는 상황
고려할 점
REST 스타일 HTTP API
URI·메서드·미디어 타입
표준 HTTP 도구·캐시 활용
화면에 따라 여러 호출이 필요할 수 있음
SOAP
XML 메시지, WSDL 계약과 관련 표준
엄격한 계약과 표준 기능이 필요한 연동
메시지와 도구 구성이 복잡할 수 있음
GraphQL
스키마·쿼리·필드 선택
화면마다 필요한 데이터가 다른 경우
쿼리 비용·권한·캐시 설계 필요
gRPC
서비스·메서드 정의, 보통 protobuf
타입 기반 코드 생성과 서버 간 통신
브라우저 연동과 운영 도구 제약 검토
보완“gRPC는 매우 빠르다”처럼 성능을 단정하기보다 데이터 크기·네트워크·구현에 따라 달라진다고 보는 것이 정확합니다. REST도 JSON만 써야 하는 것은 아닙니다.
03REST API
HTTP만으로는 “어떻게 설계하라”까지 알 수 없습니다. HTTP의 장점을 살려 일관되게 설계하자는 약속이 REST입니다.
GET /getAllPosts, POST /deletePost?id=1 같은 API도 HTTP로 동작은 합니다. 하지만 개발자마다 규칙이 제각각이라 문서 없이는 무엇을 하는 API인지 알기 어렵습니다.
REST(REpresentational State Transfer)
자원을 이름(URI)으로 구분하고, 그 자원의 상태를 표현(Representation)으로 주고받는 소프트웨어 아키텍처 스타일입니다. 2000년 HTTP 명세의 주요 저자인 로이 필딩이 박사 논문에서 제안했고, 이 원칙을 잘 지킨 API를 RESTful API라고 부릅니다.
REST = 세 가지 구성 요소
자원(Resource) — 무엇을 → URI (/posts/1)
행위(Verb) — 어떻게 → HTTP 메서드 (GET, POST, DELETE)
표현(Representation) — 어떤 형태로 → 바디 + Content-Type (JSON, XML)
POST /deletePost처럼 URI에 동사를 넣으면 메서드와 URI가 하는 일이 겹치게 됩니다.
비유
도서관에서 책 번호(URI)로 대상을 고르고, 대출·반납(메서드)으로 할 일을 정합니다. 책 번호에 “대출하기”를 적어 넣지 않습니다.
예시
행위 중심 URI → 자원 중심 URI
✗ URI에 동사가 들어감
GET  /getAllPosts
POST /createPost
POST /deletePost?id=1
GET  /post_update?id=1&title=hi
✓ 자원 + 메서드
GET    /posts
POST   /posts
DELETE /posts/1
PATCH  /posts/1  {"title":"hi"}
 DELETE     /posts/1
└─ 행위 ─┘  └─ 자원 ─┘    → "1번 post를 삭제한다"
기술 도메인
자원은 DB 테이블과 반드시 1:1이 아닙니다. 사용자에게 의미 있는 대상을 모델링합니다. 응답 JSON은 자원 그 자체가 아니라 그 시점의 자원 상태를 나타낸 표현입니다. URI는 복수형 명사로 일관되게 짓습니다.
테이블
REST의 구성 요소
구성 요소
의미
표현 방법
예시
자원(Resource)
무엇을
URI
/posts/1
행위(Verb)
어떻게
HTTP 메서드
GET, POST, DELETE
표현(Representation)
어떤 형태로
바디 + Content-Type
JSON, XML
행위 중심 경로를 자원 중심으로 바꾸기
기존 설계
개선 예시
이유
GET /getAllPosts
GET /posts
목록이라는 자원과 조회 의미 분리
POST /createPost
POST /posts
컬렉션에 생성 요청
POST /deletePost?id=1
DELETE /posts/1
삭제 의도를 메서드에 표현
GET /post_update?id=1&title=hi
PATCH /posts/1 + 변경 본문
읽기 요청 GET으로 서버 상태를 변경하지 않음
보완REST는 원래 HTTP·JSON에 한정된 정의가 아니라 분산 하이퍼미디어 시스템의 아키텍처 스타일입니다. 다만 필딩이 HTTP 표준화에 핵심적으로 참여했기 때문에 HTTP와 잘 맞고, “자원·행위·표현”은 HTTP API를 설명하는 유용한 요약입니다.
3-2REST의 6가지 제약
핵심필딩이 제시한 6가지 조건 중 Code on Demand만 선택입니다. 개발하면서 가장 신경 쓸 것은 Uniform Interface(→ 3-3)입니다.
이론
❶ Client-Server
클라이언트(UI·사용자 경험)와 서버(API·비즈니스 로직)의 관심사를 분리해 서로 독립적으로 발전할 수 있게 합니다.
❷ Stateless
서버는 클라이언트의 상태(컨텍스트)를 저장하지 않고, 요청에 처리에 필요한 정보가 모두 담겨야 합니다. HTTP의 무상태성과 같은 이야기라 서버를 늘리기 쉽습니다.
Q. 세션을 쓰면 무상태가 아닌 거 아닌가요? REST 관점에서는 엄밀히 제약을 어기는 것이 맞습니다. 하지만 HTTP 프로토콜 자체는 여전히 상태를 저장하지 않으므로 HTTP의 무상태 특성이 깨지는 것은 아닙니다. 그리고 우리는 REST API를 만드는 게 목적이 아니라 서비스를 만드는 것이 목적이므로, 요구사항에 따라 제약을 완화할 수 있습니다.
❸ Cacheable
응답은 캐시 가능 여부를 명시해야 합니다. 여기서 캐시는 서버 내부의 Redis가 아니라 브라우저·프록시·CDN 등 응답을 받는 쪽의 캐시로, 요청이 서버에 도달하기 전에 응답해 트래픽 자체를 줄이는 것이 목적입니다. 예: Cache-Control: max-age=3600
❹ Uniform Interface
모든 자원을 같은 방식으로 다룬다는 REST의 가장 핵심적인 제약입니다. → 3-3에서 자세히
❺ Layered System
클라이언트는 상대가 실제 서버인지 중간의 프록시·로드밸런서인지 알 필요가 없습니다. 1차 세미나의 Web Server(Nginx) → WAS 구조가 가능한 이유입니다.
❻ Code on Demand (선택)
서버가 클라이언트에 실행 가능한 코드(JavaScript 등)를 보낼 수 있습니다. 유일한 선택 조건입니다.
비유
창구와 손님의 역할을 나누고(Client-Server), 매번 완결된 주문서를 쓰고(Stateless), 자주 묻는 안내문은 미리 붙여 두고(Cacheable), 모든 창구가 같은 양식을 쓰며(Uniform), 손님은 접수 데스크 뒤 구조를 몰라도 되는(Layered) 민원실입니다.
예시
캐시: 재사용과 재검증은 다르다
HTTP/1.1 200 OK
Cache-Control: private, max-age=60   // 60초간 그대로 재사용 가능
ETag: "post-42-v3"

// 60초 후: 바뀌었는지만 물어보기(재검증)
GET /posts/42 HTTP/1.1
If-None-Match: "post-42-v3"

// 안 바뀌었으면 본문 없이 응답
HTTP/1.1 304 Not Modified
ETag: "post-42-v3"
no-cache는 “저장 금지”가 아니라 “재사용 전에 검증하라”이고, 저장 자체를 막는 것은 no-store입니다.
기술 도메인
Layered System ≠ 레이어드 아키텍처
REST의 계층은 클라이언트 → CDN → 리버스 프록시 → 애플리케이션처럼 네트워크 구성요소 사이의 경계입니다. Controller → Service → Repository는 프로그램 내부의 코드 구조입니다. 이름은 비슷하지만 관점이 다릅니다.
테이블
6가지 제약이 해결하는 문제
제약
정확히 나누는 것
얻는 효과·비용
Client-Server
사용자 인터페이스와 서버 데이터·처리 책임
계약을 유지하면서 독립적으로 진화
Stateless
요청 처리에 필요한 세션 문맥을 요청에 포함
분산·복구에 유리; 요청 정보 반복 비용
Cacheable
응답이 재사용 가능한지 판단할 정보 제공
지연·트래픽 감소; 오래된 데이터 제어 필요
Uniform Interface
공통된 자원·메시지·전이 규칙
구성요소 결합 완화; 일반화에 따른 비용
Layered System
직접 연결한 계층 밖의 내부 구조를 숨김
프록시·보안·로드밸런싱 도입
Code on Demand
필요할 때 실행 코드를 내려 기능 확장
클라이언트 확장; 가시성 감소, 선택 제약
보완실제로 모든 제약(특히 HATEOAS)을 엄밀히 지키는 API는 많지 않습니다. 일반적으로 “REST API”라고 하면 자원 중심 URI + HTTP 메서드 + 적절한 상태 코드 + JSON 정도를 의미합니다. 제약을 완화한 API를 엄밀한 의미의 REST라고 부르기는 어렵다는 점만 구분해 두면 됩니다.
3-3Uniform Interface와 일관된 응답 구조
핵심모든 자원을 같은 방식으로 다룹니다. 실무에서는 여기에 공통 응답 구조와 일관된 네이밍까지 맞추면 클라이언트 협업이 훨씬 쉬워집니다.
이론
네 가지 세부 조건
URI로 자원을 식별한다.
표현(JSON 등)을 통해 자원을 조작한다.
메시지만 보고도 어떻게 처리할지 알 수 있다 (Self-descriptive).
응답에 다음 행동으로 갈 수 있는 링크를 포함한다 (HATEOAS).
한 발 더: 일관된 응답 구조
공통된 응답 구조와 일관된 데이터 형태(네이밍 등)를 유지하는 것도 균일한 인터페이스에 포함된다고 보는 시각이 있습니다. 클라이언트는 서버 통신 코드를 공통 응답 구조로 한 번 추상화할 수 있어서 협업 관점에서 정말 중요합니다.
비유
지하철 안내판이 역마다 같은 양식으로 현재 위치와 갈 수 있는 출구(링크)를 보여 주면, 처음 가는 역에서도 헤매지 않습니다.
예시
✗ 성공/실패마다 모양이 다름
// 성공
{
  "id": 42,
  "title": "2차 세미나 후기",
  "createdAt": "2026-10-04T14:00:00"
}
// 실패 (400)
{
  "code": "POST_TITLE_BLANK",
  "message": "게시글 제목은 비어 있을 수 없습니다."
}
✓ 모든 응답이 같은 봉투
// 201 Created
{
  "code": "POST_CREATED",
  "message": "게시글이 생성되었습니다.",
  "data": {"id": 42, "title": "세미나 후기"}
}
// 400 Bad Request
{
  "code": "POST_TITLE_BLANK",
  "message": "게시글 제목은 비어 있을 수 없습니다.",
  "data": null
}
공통 봉투를 쓰더라도 상태 코드는 실제 결과를 반영해야 합니다. 오류일 때 data를 null로 둘지 생략할지도 계약에 명시하고, 204를 선택했다면 봉투도 보내지 않습니다.
테이블
균일한 인터페이스의 네 가지 세부 조건
조건
의미
공부할 예시
자원 식별
URI 등으로 대상을 식별
/posts/42
표현을 통한 조작
표현과 메타데이터를 통해 상태 변경
JSON 표현을 PUT으로 전달
자기 서술적 메시지
표준 의미와 미디어 타입 등으로 처리 의미 파악
메서드·상태·Content-Type·캐시 정보
HATEOAS
표현의 하이퍼미디어를 따라 가능한 상태 전이 선택
다음 페이지, 취소 가능 작업 등의 링크
보완공통 JSON 봉투는 협업을 위한 좋은 관례이지 REST 제약 자체는 아닙니다. 성공·실패 구조가 다르다고 REST 위반인 것도, 링크를 넣는다고 HATEOAS가 완성되는 것도 아닙니다.
04Spring
API를 어떻게 설계하는지 알았으니, 이제 어떻게 구현할지 봅니다. Spring의 네 가지 특징 IoC · DI · AOP · POJO와 Spring Boot를 차례로 정리합니다.
4-1Spring이란? 라이브러리 vs 프레임워크
핵심Spring은 객체를 대신 만들고 연결해 주는 컨테이너를 중심으로, 개발자가 비즈니스 로직에 집중하게 해 주는 프레임워크입니다. 라이브러리는 내가 호출하고, 프레임워크는 내 코드를 호출합니다.
이론
Spring
자바 엔터프라이즈 애플리케이션 개발을 편하게 해 주는 오픈소스 경량 프레임워크입니다. 단순히 기능을 모아 둔 라이브러리가 아니라 애플리케이션의 객체와 실행 흐름을 관리합니다.
제어 흐름의 주인이 다르다
라이브러리: 내가 필요할 때 가져다 호출합니다. (Jackson, Lombok, Collections.sort)
프레임워크: 정해진 틀 안에 내 코드를 끼워 두면, 알맞은 때에 프레임워크가 호출합니다. (Spring MVC, Spring Security)
이 “호출의 방향이 뒤집히는 것”이 바로 다음 카드의 제어의 역전(IoC)입니다.
비유
라이브러리는 공구함(내가 꺼내 쓴다), 프레임워크는 공연 무대(무대 진행표에 따라 내 차례가 오면 불려 나간다)입니다.
예시
라이브러리: 내가 호출
Collections.sort(list);
프레임워크: Spring이 내 메서드를 호출
@RestController
public class PostController {

    @GetMapping("/posts/{postId}")
    public PostResponse getPost(
            @PathVariable("postId") Long postId) {
        return postService.findPost(postId);
    }
}
getPost를 호출하는 코드는 어디에도 없습니다. GET /posts/10 요청이 오면 Spring MVC가 알아서 이 메서드를 호출합니다.
기술 도메인
개발자는 매핑(@GetMapping)과 구성(Bean 등록)으로 규칙을 선언하고, Spring은 그 규칙대로 실행합니다.
테이블
라이브러리 vs 프레임워크
라이브러리
프레임워크
제어 흐름
내가 라이브러리를 호출
프레임워크가 내 코드를 호출
예시
Jackson, Lombok
Spring MVC, Spring Security
보완원문 예시는 경로가 "/posts"인데 @PathVariable postId를 받고 있어 실제로는 동작하지 않습니다. 경로 변수를 받으려면 "/posts/{postId}"처럼 경로에 변수가 있어야 하고, 반환 타입과 Service 호출 인자도 맞춰야 합니다.
4-2IoC · 제어의 역전
핵심“어떤 객체를 만들어 누구에게 넣을지”, “어떤 메서드를 언제 호출할지”를 개발자가 아니라 Spring이 결정합니다.
이론
IoC(Inversion of Control)
애플리케이션의 제어를 개발자가 아닌 외부에서 관리하는 것입니다. 1차 과제처럼 일반 프로그램에서는 개발자가 직접 객체를 new하고 의존성을 연결하고 메서드를 호출합니다.
요청 실행: HTTP 요청에 따라 알맞은 Controller 메서드를 호출합니다. (→ Spring MVC)
비유
직접 장 보고 요리하던 사람(개발자)이 밀키트 서비스(Spring)를 쓰면, 재료 준비와 배달은 서비스가 하고 나는 조리법(비즈니스 로직)에만 집중합니다.
예시
✗ 개발자가 직접 제어
class PostService {
    // 내가 생성하고 내가 선택
    private final PostRepository postRepository
        = new PostRepository();
}
✓ 제어의 역전
class PostService {
    private final PostRepository postRepository;

    // 누가 만들어 넣어 줄지 PostService는 모른다
    public PostService(PostRepository postRepository) {
        this.postRepository = postRepository;
    }
}
조립을 누가 하는가
// 순수 Java: main에서 직접 조립
PostRepository repository = new MemoryPostRepository();
PostService service = new PostService(repository);
PostController controller = new PostController(service);

// Spring: 어노테이션만 붙이면 컨테이너가 조립
@Repository class MemoryPostRepository implements PostRepository { }
@Service    class PostService { PostService(PostRepository r) { ... } }
기술 도메인
개발자는 여전히 의존성 타입, Bean 등록, URL 매핑을 정의합니다. Spring이 비즈니스 흐름을 임의로 정하는 것이 아니라 선언된 규칙을 실행하는 것이고, Service 안에서 도메인 메서드를 호출하는 순서는 여전히 애플리케이션 코드가 정합니다.
4-3DI · 의존성 주입
핵심필요한 객체를 안에서 만들지 않고 밖에서 받습니다. 그래야 인터페이스(추상화)에만 의존할 수 있어 구현 교체와 테스트가 쉬워집니다.
이론
DI(Dependency Injection)
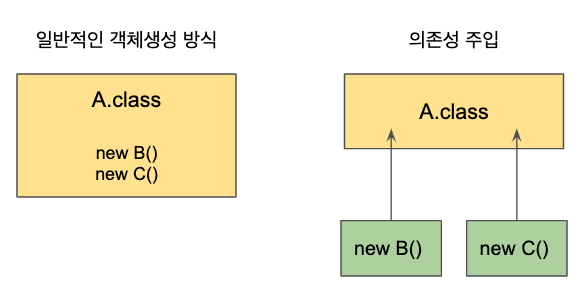
객체가 필요한 의존성을 직접 생성하지 않고 외부에서 주입받는 것입니다. Spring에서는 IoC 컨테이너가 이 주입을 대신해 줍니다.
DI와 DIP는 왜 같이 다닐까?
1차 세미나의 의존성 역전 원칙(DIP)은 “구현체가 아닌 추상화에 의존하라”였습니다. 그런데 인터페이스는 new로 인스턴스를 만들 수 없으므로, 객체 안에서 직접 생성하면 결국 new PostMysqlRepository()처럼 구현체를 알게 됩니다. 밖에서 주입받아야 추상화에만 의존할 수 있습니다.
세 개념 정리
DIP — 추상화에 의존하라 (설계 원칙)
DI — 의존 객체를 외부에서 넣어 준다 (구현 기법)
IoC — 제어권이 프레임워크로 넘어간다 (더 큰 개념)
의존성 주입(DI)
비유
스탠드가 전구를 직접 만들어 붙박이로 넣으면 전구가 나갔을 때 스탠드째 바꿔야 합니다. 규격 소켓(인터페이스)을 두고 전구를 밖에서 끼우면(주입) LED든 백열등이든 갈아 끼울 수 있습니다.
예시
✗ 주입이 아니면 결국 구현체에 의존
class PostService {
    private final PostRepository postRepository
        = new PostMysqlRepository();
}
✓ 주입으로 인터페이스에만 의존
class PostService {
    private final PostRepository postRepository;

    public PostService(PostRepository postRepository) {
        this.postRepository = postRepository;
    }
}
저장소 구현과 테스트를 바꾸는 지점
interface PostRepository { void save(Post post); }

class MemoryPostRepository implements PostRepository { ... }  // 실습·테스트용
class MysqlPostRepository  implements PostRepository { ... }  // DB 연동

PostService forPractice = new PostService(new MemoryPostRepository());
PostService forDatabase = new PostService(new MysqlPostRepository());
기술 도메인
DI는 Spring 없이도 쓸 수 있는 기법이고, Spring은 이를 자동화합니다. 같은 인터페이스의 구현체가 여러 개 Bean으로 등록되면 어떤 것을 넣을지 모호해지므로 @Primary나 @Qualifier로 선택 기준을 명시합니다.
테이블
DI·DIP·IoC를 혼동하지 않는 기준
개념
질문
예시
IoC
생성·실행의 제어를 누가 갖는가?
컨테이너가 객체를 만들고 MVC가 Controller 호출
DI
필요한 객체를 어떻게 얻는가?
생성자 인자로 Repository를 전달받음
DIP
소스 코드의 의존 방향이 어디로 향하는가?
Service가 저장 기술 대신 Repository 추상화에 의존
보완“DI와 DIP는 항상 같이 적용된다”는 엄밀히는 아닙니다. 구체 클래스도 주입할 수 있고(DI ○, DIP ✗), DIP는 추상화의 소유권과 의존 방향까지 다룹니다. 다만 DIP를 실현하려면 DI가 사실상 필요하다는 방향으로 이해하면 정확합니다.
4-4AOP · 관점 지향 프로그래밍
핵심트랜잭션·로깅처럼 여러 곳에서 반복되는 공통 관심사를 핵심 로직에서 떼어 냅니다. Spring은 프록시 + 어노테이션(@Transactional)으로 이를 제공합니다.
이론
AOP(Aspect-Oriented Programming)
여러 곳에서 반복되는 공통 관심사(aspect)를 핵심 비즈니스 로직과 분리하는 방법입니다. 직접 구현하면 같은 코드가 메서드마다 반복됩니다.
프록시가 감싼다
Spring은 원본 객체를 프록시 객체로 감싸서, 외부 호출이 프록시를 지날 때 부가 동작(트랜잭션 시작·커밋·롤백)을 실행합니다. 덕분에 구현체나 라이브러리가 바뀌어도 업무 코드는 영향을 덜 받습니다.
⚠️ self-invocation 주의
객체 내부에서 자기 메서드를 this.method()로 호출하면 프록시를 거치지 않아서 그 메서드에 붙인 AOP가 동작하지 않습니다.
비유
건물 입구 보안 게이트(프록시)는 밖에서 들어올 때만 검사합니다. 이미 안에 들어온 사람이 방에서 방으로 이동할 때(self-invocation)는 게이트를 지나지 않습니다.
예시
✗ AOP 없이: 트랜잭션 코드가 업무 코드를 덮음
public void createPost(CreatePostRequest request) {
    Connection connection = null;
    try {
        connection = dataSource.getConnection();
        connection.setAutoCommit(false);          // 트랜잭션 시작
        postRepository.save(connection, request); // ← 진짜 하고 싶은 일은 이 한 줄
        connection.commit();                      // 커밋
    } catch (Exception e) {
        if (connection != null) connection.rollback();  // 롤백
        throw e;
    } finally {
        if (connection != null) connection.close();
    }
}
✓ AOP: 선언만 하면 프록시가 감싸 줌
@Service
class PostService {
    private final PostRepository postRepository;

    @Transactional
    public void createPost(CreatePostRequest request) {
        postRepository.save(...);
    }
}
self-invocation
외부 → [프록시: 트랜잭션 시작] → outer()   ✓ advice 적용
                                  └ this.inner()  ✗ 프록시를 다시 지나지 않음
기술 도메인
inner()에 붙인 새로운 트랜잭션 전파나 로깅은 적용되지 않지만, 바깥 메서드가 이미 시작한 트랜잭션 안에서는 실행될 수 있습니다. 해결은 책임을 나눠 다른 Bean을 통해 호출하도록 바꾸는 것부터 검토합니다. 기본 롤백 대상은 RuntimeException과 Error이고, checked exception은 rollbackFor 등 별도 설정이 필요합니다.
테이블
AOP에서 자주 만나는 용어
용어
뜻
트랜잭션 예시
Aspect
분리한 횡단 관심사
트랜잭션 관리
Advice
언제 실행할 부가 동작
실행 전 시작, 성공 시 커밋, 실패 시 롤백
Pointcut
부가 동작을 적용할 호출 조건
특정 서비스 메서드에 적용
Target
원래 업무를 수행하는 객체
PostService
Proxy
호출을 가로채 부가 동작을 수행하는 객체
외부 호출이 거치는 서비스 대리 객체
보완AOP가 모든 기술 교체를 자동으로 추상화해 주지는 않습니다. @Transactional도 트랜잭션 매니저 설정과 실제 DB 연동이 있어야 의미가 있고, 실습의 인메모리 Map은 @Transactional만으로 롤백되지 않습니다.
4-5POJO · 평범한 자바 객체
핵심Spring은 특정 클래스를 상속하거나 특정 인터페이스를 구현하라고 강요하지 않습니다. 평범한 Java 객체로 개발하므로 1차 세미나의 객체지향 원칙을 그대로 지킬 수 있습니다.
이론
POJO(Plain Old Java Object)
특정 기술이나 프레임워크에 종속되지 않은 일반 Java 객체입니다. Spring 기능을 쓰면서도 Java의 객체지향적인 장점을 유지할 수 있습니다.
왜 중요할까?
도메인 객체를 일반 클래스로 두면 프레임워크 없이도 규칙을 테스트할 수 있고, 프레임워크를 바꿔도 핵심 코드가 덜 흔들립니다. 그래서 Spring은 객체지향 원칙을 지키면서 WAS를 개발할 수 있는 프레임워크입니다.
비유
특정 브랜드 전용 부품이 아니라 표준 규격 부품으로 조립하는 것과 같습니다. 작업대(프레임워크)를 바꿔도 부품은 그대로 쓸 수 있습니다.
예시
public class Post {      // extends, implements 강요 없음
    private Long id;
    private String title;
    ...
}
기술 도메인
Spring 이전의 EJB 같은 기술은 특정 기반 클래스·인터페이스를 반드시 구현해야 했습니다. 어노테이션을 일부 붙인다고 해서 객체지향 설계가 사라지는 것은 아닙니다.
4-6Spring Boot
핵심Spring Boot는 Spring을 대체하는 것이 아니라 쉽게 쓰게 해 주는 도구입니다. 내장 Tomcat · Starter · 자동 구성 덕분에 설정 없이 바로 서버를 띄울 수 있습니다.
이론
Spring의 불편함
빈, DB 연결, 트랜잭션, MVC 등을 XML 또는 Java 설정으로 전부 직접 설정
라이브러리 간 버전 호환성을 직접 맞춤
.war로 빌드해 외부 Tomcat에 직접 배포
“Hello World”를 띄우기까지가 너무 오래 걸렸습니다.
Spring Boot
Spring 애플리케이션을 최소한의 설정으로 빠르게 만들고 실행하게 해 주는 도구입니다. @SpringBootApplication 한 줄로 컴포넌트 스캔과 자동 구성이 켜집니다.
비유
Spring이 재료와 주방 도구라면, Spring Boot는 재료 손질과 도구 배치가 끝난 밀키트입니다. 원하면 간을 바꿀 수 있지만(설정 변경), 기본값만으로도 바로 요리할 수 있습니다.
예시
@SpringBootApplication   // 이 한 줄로 컴포넌트 스캔 + 자동 구성
public class SeminarApplication {
    public static void main(String[] args) {
        SpringApplication.run(SeminarApplication.class, args);
    }
}
외부 설정과 실행
# src/main/resources/application.yml
server:
  port: 8080
spring:
  application:
    name: seminar-board

# 터미널
./gradlew bootRun                       # 개발 중 실행
./gradlew bootJar                       # 실행 가능한 jar 빌드
java -jar build/libs/생성된-파일명.jar
기술 도메인
자동 구성은 조건부로 동작합니다. 클래스패스의 라이브러리, 설정 값, 이미 등록된 Bean을 보고 필요한 Bean을 등록하고, 개발자가 같은 Bean을 직접 정의하면 자동 구성은 물러납니다. JPA를 추가해도 DataSource·드라이버·접속 설정이 맞아야 DB 연결이 완성됩니다.
테이블
Spring Boot의 주요 기능
기능
설명
내장 서버
Tomcat을 내장해, java -jar app.jar 하나로 서버 실행
Starter 의존성
spring-boot-starter-web 하나만 추가하면 웹 개발에 필요한 라이브러리를 호환되는 버전으로 한 번에
자동 구성 (Auto Configuration)
클래스패스에 있는 라이브러리를 보고 필요한 빈을 자동 등록 (예: JPA가 있으면 EntityManager 등록)
외부 설정
application.yml로 포트, DB 주소 등을 코드 밖에서 관리
운영 기능 (Actuator)
헬스 체크, 메트릭 등 모니터링 기능 제공
Spring vs Spring Boot
Spring
Spring Boot
설정
개발자가 직접
자동 구성 + 필요한 것만 변경
서버
외부 WAS에 배포
내장 Tomcat
빌드 결과
.war
실행 가능한 .jar
의존성 관리
버전 직접 관리
Starter + 버전 자동 관리
POJO의 의미와 Boot가 해결하는 설정 부담
Boot 기능
직접 준비하던 작업
Boot에서의 변화
Starter
필요한 웹 라이브러리 묶음 선정
용도별 의존성 묶음 제공
의존성 관리
라이브러리 버전 조합 관리
관리되는 버전 집합 제공
자동 구성
MVC·DataSource 등 Bean 구성
클래스패스·속성·기존 Bean 등의 조건에 따라 구성
내장 서버
별도 서버 설치와 배포 준비
실행 가능한 애플리케이션으로 구동
외부 설정
환경별 값을 코드에 하드코딩
프로퍼티·YAML·환경변수 등으로 분리
Actuator
운영 상태 확인 기능 직접 구현
추가 의존성·설정을 통해 헬스·메트릭 제공
보완“Spring = war, Boot = jar”는 절대적인 구분이 아닙니다. Spring도 Java 설정과 다양한 배포 방식을 쓸 수 있고, Boot도 war 배포를 지원합니다. 대표적인 경향으로 이해하면 됩니다.
05Spring의 내부 구조
Spring을 본격적으로 쓰기 전에, 객체(Bean)가 어떻게 만들어지고 관리되는지 봅니다. Bean → Container → Singleton → 주입 방식 순서로 이어집니다.
5-1Bean과 등록 방법
핵심Bean은 Spring Container가 생성하고 관리하는 객체입니다. 직접 만든 클래스는 @Service 같은 어노테이션(Component Scan)으로, 외부 라이브러리 객체는 @Bean으로 등록합니다.
이론
Bean이란?
일반 객체는 new로 직접 만들어 쓰지만, @Service를 붙인 클래스는 Spring Bean으로 등록되어 Container가 생명주기를 관리하고 필요한 곳에 자동으로 주입합니다.
① Component Scan — 가장 일반적인 방법
@Controller, @RestController, @Service, @Repository가 붙은 클래스를 Spring이 찾아 Bean으로 등록합니다. 애플리케이션이 시작될 때 한 번 일어나며, 이 어노테이션들은 모두 내부적으로 @Component를 기반으로 합니다.
② @Bean — 직접 등록
@Configuration 클래스 안의 @Bean 메서드가 반환하는 객체를 Bean으로 관리합니다. 단순 생성이 아니라 생성 방법을 제어해야 할 때(옵션 설정, 외부 라이브러리 객체) 주로 씁니다.
결정적인 차이
Bean으로 쓸 객체를 만들 때 별도의 설정이나 제어가 필요하냐입니다. (XML 등록 방식도 있지만 거의 쓰이지 않아 생략합니다.)
비유
Component Scan은 사원증을 단 직원을 자동으로 명단에 올리는 것, @Bean은 계약 조건을 직접 정해 외부 전문가를 초빙하는 것입니다.
예시
일반 객체
private final PostService postService
    = new PostService();
postService.createPost(request);
Spring Bean
@Service
public class PostService {
    ...
}
@Bean: 생성 방법을 직접 제어
@Configuration
public class AppConfig {

    @Bean
    public PasswordEncoder passwordEncoder() {
        return new BCryptPasswordEncoder();
    }

    @Bean
    public ObjectMapper objectMapper() {
        ObjectMapper mapper = new ObjectMapper();
        mapper.findAndRegisterModules();   // 내가 원하는 설정
        return mapper;
    }
}
외부 객체를 Bean으로 등록해 주입받기
@Configuration
class TimeConfig {
    @Bean
    Clock clock() { return Clock.systemUTC(); }   // Clock 소스에 @Component를 붙일 수 없음
}

@Service
class PostService {
    private final Clock clock;
    PostService(Clock clock) { this.clock = clock; }   // 테스트에서는 고정 시계로 교체 가능
    Instant now() { return Instant.now(clock); }
}
기술 도메인
@SpringBootApplication의 기본 스캔 범위는 그 클래스의 패키지와 하위 패키지입니다. 범위 밖의 클래스는 @Service를 붙여도 등록되지 않습니다. 또 new로 직접 만든 객체는 Bean이 아니며, Post 같은 도메인 객체나 요청 DTO는 Bean으로 만들 필요가 없습니다.
테이블
객체가 존재하는 것과 Bean인 것은 다릅니다
방식
등록 대상
대표 사용
Component Scan
스캔 대상의 stereotype 클래스
직접 작성한 Controller·Service·Repository
@Bean
팩토리 메서드가 반환하는 객체
외부 라이브러리 객체, 생성 옵션 제어
@Import / 명시적 설정 등록
설정 클래스 등을 로드
스캔 외 방식으로 구성 연결
보완원문은 “@Configuration도 @Component 기반이므로 @Bean 등록도 결국 Component Scan에 포함된다”고 설명합니다. 설정 클래스가 스캔으로 발견되는 경우가 많은 것은 맞지만, @Bean 등록 자체는 스캔과 별개의 메커니즘이고 설정 클래스는 @Import 등으로도 로드할 수 있습니다.
5-2Spring Container
핵심Bean = Spring이 관리하는 객체, Container = Bean을 관리하는 관리자. 코드에서 Container 역할을 하는 것이 ApplicationContext이고, 앱이 시작될 때 필요한 Bean을 미리 만들어 연결해 둡니다.
이론
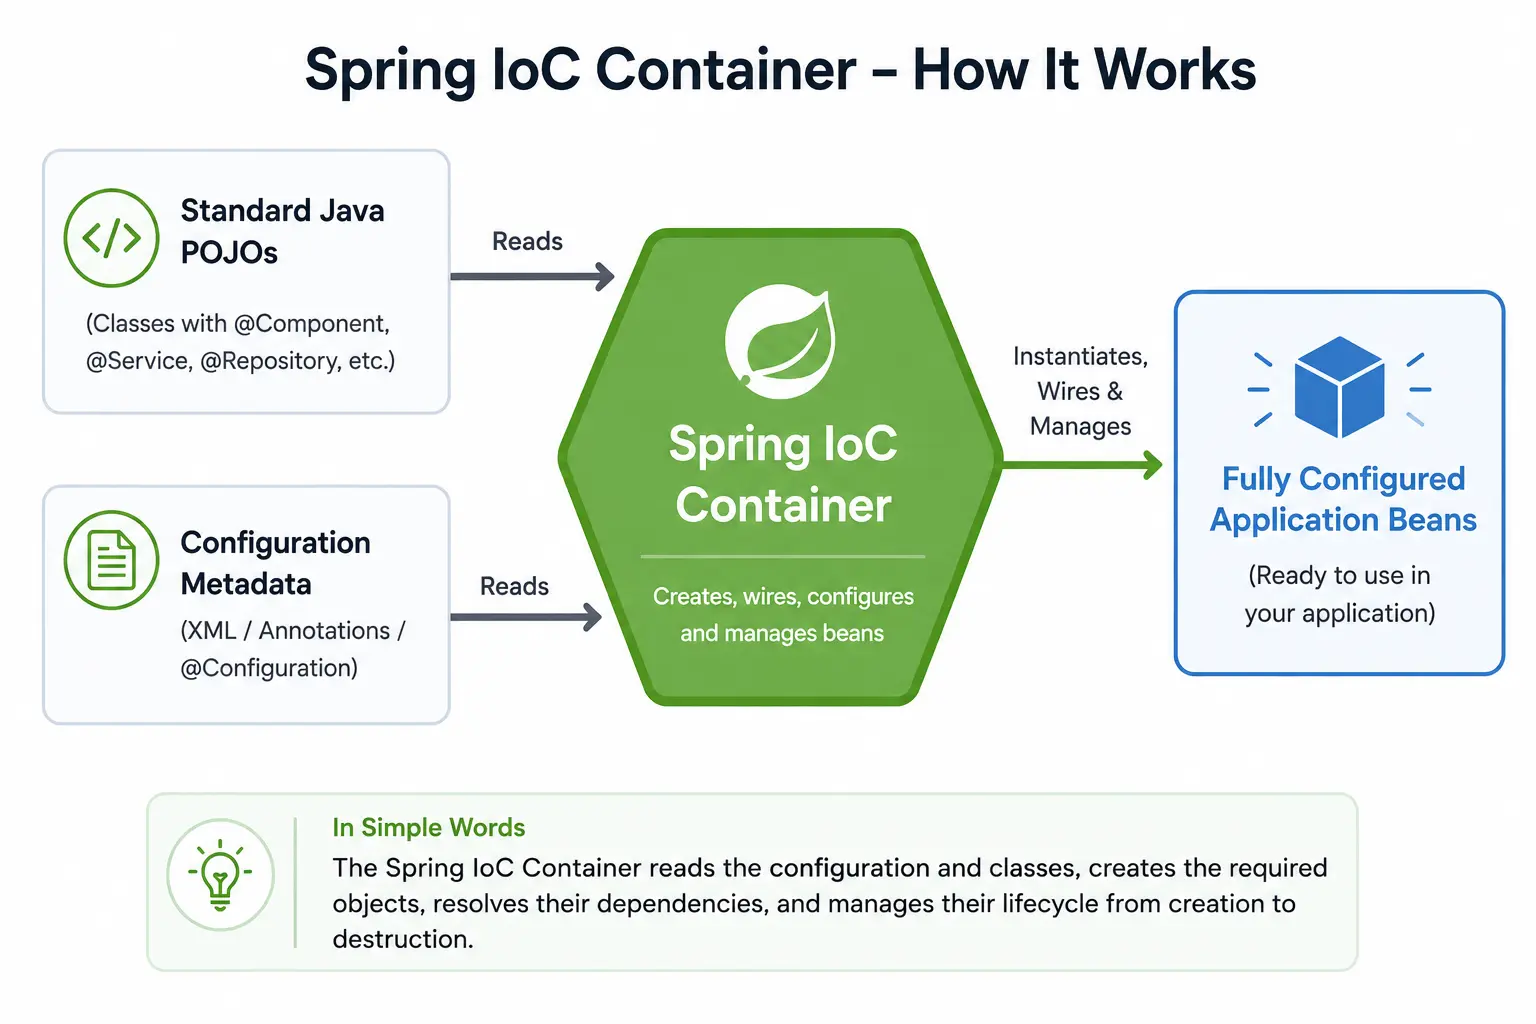
Spring Container
Bean을 생성·관리하고, Bean 사이의 의존관계를 연결하고, 생명주기를 관리합니다. IoC와 DI의 주체이므로 IoC Container, DI Container라고도 부릅니다.
BeanFactory
Bean을 생성하고 관리하는 핵심 컨테이너 기능입니다. Bean의 생성, 저장, 의존성 주입을 담당합니다.
ApplicationContext
Spring Container를 대표하는 인터페이스, 즉 Container라는 개념을 코드로 동작하게 만든 객체입니다. BeanFactory를 상속받아 그 기능을 모두 제공하면서 이벤트 발행, application.yml 같은 설정(Environment) 관리, 생명주기 관리 등 부가 기능까지 제공합니다.
그래서 new를 안 써도 된다
Controller나 Service를 직접 new하지 않아도 되는 이유는, 애플리케이션이 시작될 때 Spring이 필요한 객체를 미리 준비하기 때문입니다.
Spring IoC Container의 동작IoC Container: BeanFactory와 ApplicationContext
비유
BeanFactory는 물건을 만들고 보관하는 창고, ApplicationContext는 그 창고에 안내 방송·설정 관리·출입 기록까지 더한 물류 운영 센터입니다.
예시
컨테이너가 동작하는 과정
SpringApplication.run()애플리케이션 시작
ApplicationContext 생성웹 애플리케이션에 맞는 컨테이너 구현체가 만들어짐
Bean 정보 수집Component Scan, @Bean 메서드 탐색 → “어떻게 만들지”(Bean 정의) 등록
Bean 생성 + 의존관계 연결생성자 주입이면 의존 대상이 먼저 필요: Repository → Service → Controller 순
Bean 초기화 · 후처리초기화 콜백, AOP 프록시 적용 등
애플리케이션 실행HTTP 요청을 처리할 준비 완료 (종료 시에는 종료 콜백 수행)
기술 도메인
Bean 정의(클래스·생성자 인자·scope 등 “설계도”)와 Bean 인스턴스(실제 객체)를 구분해 두면 흐름이 명확해집니다. @Transactional의 프록시는 BeanPostProcessor 같은 후처리 단계에서 적용됩니다.
보완Component Scan은 BeanFactory 인터페이스 자체의 기능이라기보다 ApplicationContext의 스캐너·설정 처리 인프라가 수행합니다. 또 “IoC Container = DI Container”는 엄밀히 같은 개념은 아니며, 모든 Bean이 시작 시점에 생성되는 것도 아닙니다(lazy·scope에 따라 다름).
5-3Singleton과 동시성
핵심Bean은 기본적으로 하나만 만들어 모든 요청이 공유합니다(Singleton). 그래서 Bean에 요청별 데이터를 필드로 저장하면 안 됩니다. 지역 변수·파라미터로 처리하는 Stateless 구조로 설계합니다.
이론
Singleton Scope
하나의 Spring Container 안에서 Bean 인스턴스를 하나만 만들어 공유합니다. 요청이 초당 1,000번 오는데 매번 PostService를 새로 만들면 메모리 사용량과 객체 생성 비용, GC 부담이 커지기 때문입니다.
문제: 스레드가 객체를 공유한다
Spring MVC는 기본적으로 요청마다 다른 스레드(Thread per Request)로 처리하고, 스레드들은 Heap을 공유합니다. 즉 모든 스레드가 같은 Bean 객체를 동시에 씁니다. 1차 세미나의 동시성 문제가 그대로 생깁니다.
해결: Stateless하게
요청별 데이터는 지역 변수나 파라미터로 다룹니다. 지역 변수는 스레드마다 따로 생기는 Stack에 있으므로 공유되지 않습니다. final Repository 필드처럼 바뀌지 않는 의존 객체 참조는 공유해도 괜찮습니다.
비유
사무실에 공용 화이트보드 하나(싱글톤 필드)만 두고 모두가 자기 이름을 덮어 쓰면 다른 사람 작업과 섞입니다. 각자 개인 메모지(지역 변수)에 쓰면 문제가 없습니다.
예시
✗ 요청별 값을 필드에 저장
@Service
public class MemberService {
    private String currentMember;

    public void process(String member) {
        currentMember = member;
        // 작업 수행
    }
}
✓ 지역 변수·파라미터로 처리
@Service
public class MemberService {

    public void process(String member) {
        String message = "안녕하세요, " + member;
        sendResult(message);
    }
}
어떻게 꼬이는가
Thread A: currentMember = "Alice";
Thread B: currentMember = "Bob";
Thread A: sendResult(currentMember);   // Alice가 아니라 Bob으로 처리될 수 있음!
기술 도메인
저장소처럼 의도적으로 상태를 공유해야 하는 Bean은 동시성 정책을 명시해야 합니다. ConcurrentHashMap도 “조회 후 수정”, “ID 발급 후 저장” 같은 복합 동작까지 자동으로 원자화하지는 않습니다.
테이블
Scope와 thread-safe를 구분하기
Scope
공유 범위
학습 포인트
singleton
Bean 정의당 컨테이너에서 하나
기본값; 공유 필드의 동시성 주의
prototype
요청해서 얻을 때 새 객체
singleton에 한 번 주입하면 자동으로 매번 새로 바뀌지는 않음
request
웹 요청 하나
웹 환경 전용; 요청 데이터 수명과 연결
session
HTTP 세션 하나
사용자 세션별 수명; 여러 동시 요청은 가능
보완Spring이 singleton을 쓴다고 Bean이 자동으로 thread-safe해지지는 않습니다. 또 지역 변수에 공유 가변 객체의 참조를 담았다면 그 객체까지 안전해지는 것은 아닙니다. (WebFlux·비동기 처리는 Servlet MVC와 스레드 모델이 다릅니다.)
5-4의존성 주입 방식 3가지
핵심필드 · Setter · 생성자 주입 중 생성자 주입을 씁니다. final로 불변을 보장하고, 의존성 누락과 순환 참조를 일찍 발견하며, Spring 없이도 테스트할 수 있습니다.
이론
필드 주입 비권장
Spring이 객체를 만든 뒤 필드에 넣어 줍니다. 가장 간단하지만 final을 쓸 수 없고, Spring 없이 new로 만들면 의존성이 비어 있어 테스트가 어렵습니다. 거의 쓰이지 않습니다.
수정자(Setter) 주입 제한적
객체 생성 후 Setter를 호출해 넣습니다. 역시 final을 쓸 수 없지만, 선택적이거나 바뀔 수 있는 의존성을 표현할 때 제한적으로 씁니다.
생성자 주입 권장
객체가 만들어지는 순간 생성자로 의존성을 받습니다. 생성 시점에 의존성이 결정되므로 final로 불변을 보장하고, 순환 의존을 시작 시점에 발견할 수 있습니다. 가장 많이 쓰이는 방법입니다.
비유
생성자 주입은 필수 부품이 다 있어야 조립이 끝나는 공장입니다. 부품이 빠지면 출고(애플리케이션 시작) 전에 바로 걸립니다. 필드 주입은 일단 출고한 뒤 부품을 끼우는 방식이라, 빠진 것을 늦게 발견합니다.
예시
✗ 필드 주입
@Service
public class PostService {
    @Autowired
    private PostRepository postRepository;
}
△ Setter 주입
@Service
public class PostService {
    private PostRepository postRepository;

    @Autowired
    public void setPostRepository(PostRepository postRepository) {
        this.postRepository = postRepository;
    }
}
✓ 생성자 주입
@Service
public class PostService {
    private final PostRepository postRepository;

    public PostService(PostRepository postRepository) {   // 생성자가 하나면 @Autowired 생략 가능
        this.postRepository = postRepository;
    }
}

// 테스트: Spring 없이 가짜 저장소로 바로 생성
PostService service = new PostService(new FakePostRepository());
기술 도메인
순환 의존
A의 생성자에 B가, B의 생성자에 A가 필요하면 생성 순서를 만족할 수 없어 컨테이너 생성이 실패합니다. Setter로 우회하기보다 책임이 과하게 얽혀 있는지 점검하고 공통 책임을 별도 객체로 분리하는 편이 좋습니다.
테이블
생성자 주입을 사용해야 하는 이유
이유
설명
불변성
final로 선언해 주입 이후 변경을 막을 수 있음
누락 방지
의존 객체 없이는 객체 생성 자체가 불가능 → 컴파일 시점에 발견
테스트 용이
Spring 없이도 new PostService(new FakeRepository())로 테스트 가능
순환 참조 조기 발견
애플리케이션 시작 시점에 바로 오류
보완“컴파일 시점에 발견”은 new로 직접 호출할 때의 이야기입니다. Spring이 주입할 Bean이 없거나 후보가 여러 개인 문제는 보통 컴파일이 아니라 애플리케이션 시작 시점에 드러납니다. 또 final은 참조 재할당을 막을 뿐, 참조 대상 객체의 내부 상태까지 불변으로 만들지는 않습니다.
06Spring MVC
API를 구현하기 전 마지막 단계입니다. 클라이언트의 HTTP 요청이 어떤 과정을 거쳐 Controller에 도착하고, 다시 응답이 되는지 따라가 봅니다.
6-1Tomcat과 Spring MVC
핵심Tomcat은 Servlet이 실행될 수 있는 환경(WAS)을 제공하고, Spring MVC는 그 위에서 HTTP 요청을 처리하는 웹 프레임워크입니다.
이론
Spring MVC
Spring에서 웹 애플리케이션의 HTTP 요청과 응답을 처리하는 프레임워크입니다. GET /posts/10 요청을 알맞은 Controller와 연결하고, Controller의 결과를 다시 HTTP 응답으로 만들어 줍니다.
역할 구분
Tomcat: 네트워크로 들어온 HTTP 요청을 Servlet 요청·응답 객체로 만들어 Servlet에 전달합니다.
Spring MVC: 그 Servlet 환경 위에서 DispatcherServlet을 중심으로 요청을 처리합니다.
Spring Boot와 내장 Tomcat
Spring Boot가 내장 Tomcat을 포함한 실행 환경을 구성해 주므로 Tomcat을 따로 설치하지 않아도 앱을 실행할 수 있습니다.
비유
Tomcat은 건물과 전기·수도 설비, Spring MVC는 그 건물 1층에 차린 민원 접수 창구 시스템입니다. 건물이 있어야 창구를 열 수 있고, 창구가 손님을 담당 부서로 안내합니다.
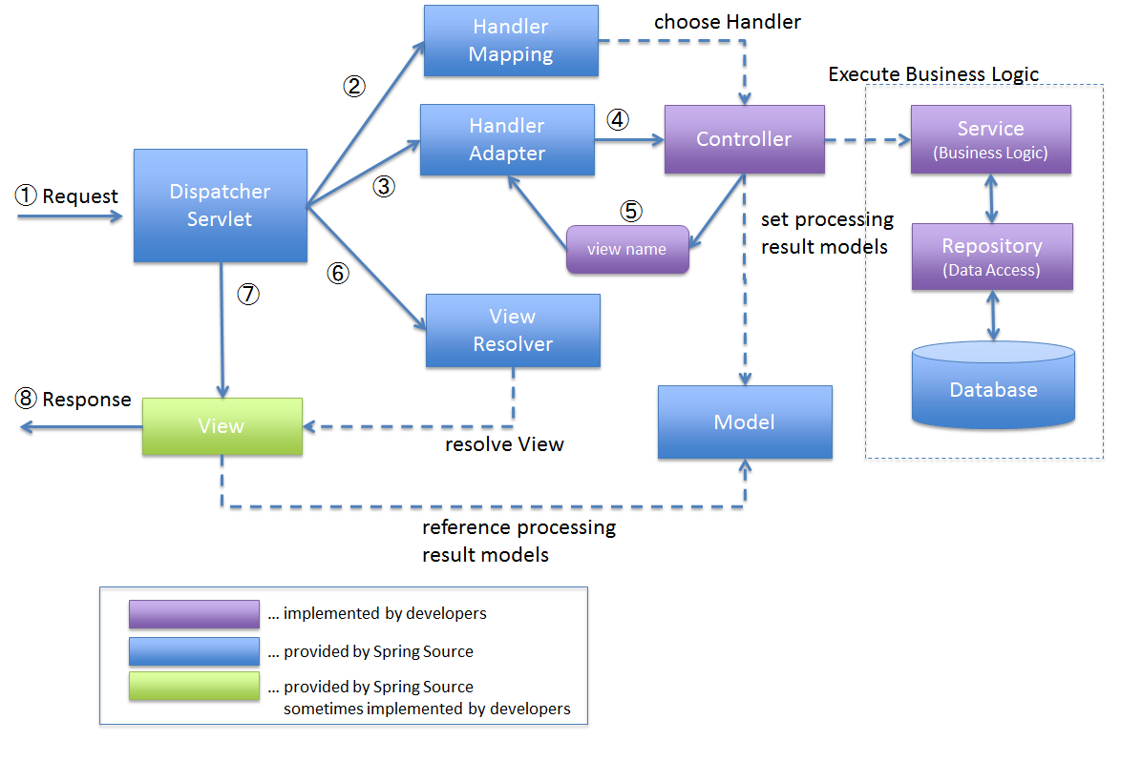
모든 요청을 하나의 진입점으로 모은 뒤 알맞은 Controller에 전달하는 Front Controller 패턴의 구현체입니다. 직접 모든 일을 하지 않고, 각 구성요소에 작업을 위임하면서 전체 흐름을 조율합니다.
❷ HandlerMapping — “이 요청은 누가 처리하지?”
GET /posts 요청이 오면 @GetMapping("/posts")가 붙은 Handler를 찾아 줍니다. 여기서 Handler는 Controller 클래스만이 아니라 실행할 메서드까지 포함하는 개념입니다.
❸ HandlerAdapter — “찾은 Handler를 실행”
Handler의 종류마다 실행 방법이 다를 수 있는데, HandlerAdapter가 이를 추상화해서 DispatcherServlet이 모든 실행 방식을 알 필요가 없게 합니다.
❹ Argument Resolver — “파라미터에 무슨 값을 넣지?”
Controller 메서드의 파라미터 어노테이션과 타입을 보고, HTTP 요청에서 값을 꺼내 넣어 줍니다. 덕분에 개발자는 요청을 직접 파싱하지 않습니다. @RequestBody는 Argument Resolver가 맡되, 실제 JSON ↔ Java 객체 변환은 HttpMessageConverter가 담당합니다.
❺ Controller
HTTP 요청을 받아 애플리케이션의 처리 로직(Service)으로 연결하는 진입점입니다. 메서드가 실행될 때 파라미터에는 이미 Argument Resolver가 추출한 값이 들어 있습니다.
Spring MVC 구조
비유
병원에 비유하면 DispatcherServlet = 접수처, HandlerMapping = “정형외과 3번 진료실로 가세요” 안내, HandlerAdapter = 진료실 연결, Argument Resolver = 진료에 필요한 서류(차트·검사 결과) 준비, Controller = 의사입니다.
예시
GET /posts/10?keyword=spring 요청을 따라가 보기
DispatcherServlet요청을 받고 처리 흐름 시작
HandlerMapping@GetMapping("/posts/{postId}")가 붙은 PostController.getPost를 찾음
HandlerAdapter찾은 Handler 메서드를 실행할 준비
Argument Resolver@PathVariable postId ← 10, @RequestParam keyword ← "spring" (문자열 "10" → Long 10 변환 포함)
Controller 실행getPost(10L, "spring") 호출 → Service로 연결
@GetMapping("/posts/{postId}")
public PostResponse getPost(
        @PathVariable("postId") Long postId,
        @RequestParam("keyword") String keyword
) {
    return postService.findPost(postId, keyword);
}
JSON 본문이 객체로 바뀌는 위치
POST /posts
Content-Type: application/json

{"title":"MVC 학습","content":"요청 흐름 확인"}

@PostMapping("/posts")
public PostResponse create(@RequestBody CreatePostRequest request) { ... }

// Body bytes → HttpMessageConverter → CreatePostRequest → Controller 호출
기술 도메인
HandlerMapping은 경로뿐 아니라 HTTP 메서드·consumes·produces 같은 조건도 봅니다. 어노테이션 Controller는 보통 RequestMappingHandlerMapping / RequestMappingHandlerAdapter가 담당합니다. 타입 변환이나 필수 값 확인이 실패하면 Controller 본문이 실행되기 전에 400 오류가 날 수 있습니다(예: /posts/abc).
테이블
요청 데이터와 매핑되는 Controller 파라미터
Controller 파라미터
HTTP 요청의 어디에서 가져오는가?
예시
@PathVariable
URL Path
/posts/10 → 10
@RequestParam
Query Parameter
?keyword=spring → "spring"
@RequestHeader
HTTP Header
Authorization: Bearer ...
@CookieValue
Cookie
Cookie: sessionId=abc
@RequestBody
HTTP Request Body
JSON → Java 객체
바인딩 어노테이션의 입력 위치와 실패 지점
어노테이션
입력 위치
주의할 점
@PathVariable
경로 템플릿의 변수
/posts/abc를 Long으로 변환하면 오류
@RequestParam
쿼리·form 파라미터
필수 여부·기본값·빈 문자열 정책
@RequestHeader
요청 헤더
헤더 누락과 인증 실패의 책임 구분
@CookieValue
요청 쿠키
쿠키의 존재와 세션 유효성은 다름
@RequestBody
요청 본문
메시지 컨버터로 역직렬화
@ModelAttribute
주로 쿼리·form 값을 객체에 바인딩
JSON 본문 변환과 다름
@RequestPart
multipart의 특정 part
파일 또는 part별 본문 변환
보완모든 네트워크 요청이 무조건 DispatcherServlet을 지나는 것은 아닙니다. Servlet 매핑과 Filter·Security의 선행 처리에 따라 그 전에 응답이 끝날 수 있습니다. 또 @RequestBody(required = true)는 “본문이 반드시 있어야 한다”는 뜻이지 DTO의 모든 필드가 필수가 된다는 뜻은 아닙니다.
6-3응답이 만들어지는 두 갈래
핵심JSON 응답은 HttpMessageConverter가 객체를 JSON으로 바꿔 바로 씁니다. HTML 응답(SSR)은 Controller가 view 이름을 돌려주면 ViewResolver가 View를 찾아 렌더링합니다. REST API 서버는 주로 JSON 갈래를 씁니다.
Controller는 HTML의 이름(view name)을 반환합니다. DispatcherServlet은 ViewResolver에게 view name에 맞는 View를 찾게 하고, 찾은 View에 Model 데이터를 넘겨 렌더링한 HTML을 응답에 씁니다.
@RestController = @Controller + @ResponseBody
@Controller에서 반환한 String은 보통 뷰 이름, @RestController에서는 응답 본문으로 처리됩니다.
비유
JSON 응답은 재료(데이터)를 포장해 그대로 배달하는 것, HTML 응답은 주방에서 완성된 요리(페이지)로 만들어 내보내는 것입니다. 앱·프론트엔드는 재료를 받아 직접 화면을 그립니다.
예시
JSON 응답 (REST API)
Controller객체 반환
HttpMessageConverter객체 → JSON
HttpServletResponse응답 본문에 기록
Tomcat → ClientHTTP 응답 전송
HTML 응답 (SSR)
Controllerview name + Model 반환
DispatcherServlet → ViewResolver이름으로 View 탐색
View.render(model)HTML 렌더링
Tomcat → ClientHTTP 응답 전송
// JSON/API 응답
@RestController
class PostApiController {
    @GetMapping("/api/posts/{id}")
    PostResponse get(@PathVariable("id") Long id) {
        return service.findById(id);              // → JSON 본문
    }
}

// 서버에서 템플릿 렌더링 (템플릿 엔진 설정 필요)
@Controller
class PostPageController {
    @GetMapping("/posts/{id}")
    String page(@PathVariable("id") Long id, Model model) {
        model.addAttribute("post", service.findById(id));
        return "posts/detail";                    // → 뷰 이름
    }
}
기술 도메인
반환 값은 HandlerMethodReturnValueHandler가 해석합니다. ResponseEntity를 쓰면 본문뿐 아니라 상태 코드와 헤더도 정할 수 있습니다. 처리 중 예외는 HandlerExceptionResolver 체계로 넘어가며, @ExceptionHandler·@RestControllerAdvice도 이 흐름과 연결됩니다(→ 0-2).
보완HttpMessageConverter가 “새 응답 객체를 만들어 Tomcat에 반환”한다기보다, Servlet API의 HttpServletResponse응답 스트림에 데이터를 쓰는 것입니다. 또 ViewResolver는 정적 HTML 파일만 찾는 것이 아니라 템플릿 엔진(Thymeleaf 등)의 View를 찾습니다.
07실습 · Spring으로 마이그레이션
세미나 내용을 바탕으로 1차 과제를 Spring으로 옮깁니다. 역할과 책임에 따라 객체를 잘 나눠 두었다면 네 단계로 끝나는 쉬운 과정입니다.
STEP 1빌드 설정과 진입점
핵심build.gradle에 Boot 플러그인 2개 + webmvc 의존성을 추가하고, Main에 @SpringBootApplication과 SpringApplication.run()을 넣으면 Spring 서버가 뜹니다.
이론
바뀌는 것은 두 파일뿐
build.gradle: Spring Boot 플러그인, 의존성(버전) 관리 플러그인, Spring WebMVC 의존성 추가
Main: 설정 자동화 어노테이션(@SpringBootApplication)과 실행 코드(SpringApplication.run) 추가
이렇게 간단한 변경만으로 Spring을 실행할 수 있게 해 주는 것이 바로 Spring Boot입니다.
순서
build.gradle 수정 → Gradle 동기화 (실행 전에 한 번 필요)
Main 수정 → 실행
브라우저에서 http://localhost:8080 접속 → 아래 화면이 보이면 성공
비유
기존 작업장(도메인·서비스 코드)은 그대로 두고, 건물에 접수 시스템과 전기 설비(Spring Boot + 내장 Tomcat)만 새로 설치하는 공사입니다.
예시
build.gradle — 초록색 줄이 추가된 부분
plugins {
    id 'java'
    id 'org.springframework.boot' version '4.0.8'    id 'io.spring.dependency-management' version '1.1.7'}

group = 'org.sopt'
version = '1.0-SNAPSHOT'

repositories {
    mavenCentral()
}

dependencies {
    implementation 'org.springframework.boot:spring-boot-starter-webmvc'    testImplementation 'org.springframework.boot:spring-boot-starter-webmvc-test'    testImplementation platform('org.junit:junit-bom:6.0.0')
    testImplementation 'org.junit.jupiter:junit-jupiter'
    testRuntimeOnly 'org.junit.platform:junit-platform-launcher'
}

test {
    useJUnitPlatform()
}
Main.java
package org.sopt;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplicationpublic class Main {

    public static void main(String[] args) {
        SpringApplication.run(Main.class, args);    }
}
패키지 배치
src/main/java/org/sopt/
  Main.java                  ← 최상위 패키지에 둔다
  controller/PostController.java
  service/PostService.java
  repository/PostRepository.java
  domain/Post.java
  dto/CreatePostRequest.java, UpdatePostRequest.java, PostResponse.java
src/main/resources/
  application.yml
  static/index.html          ← 필요할 때 추가
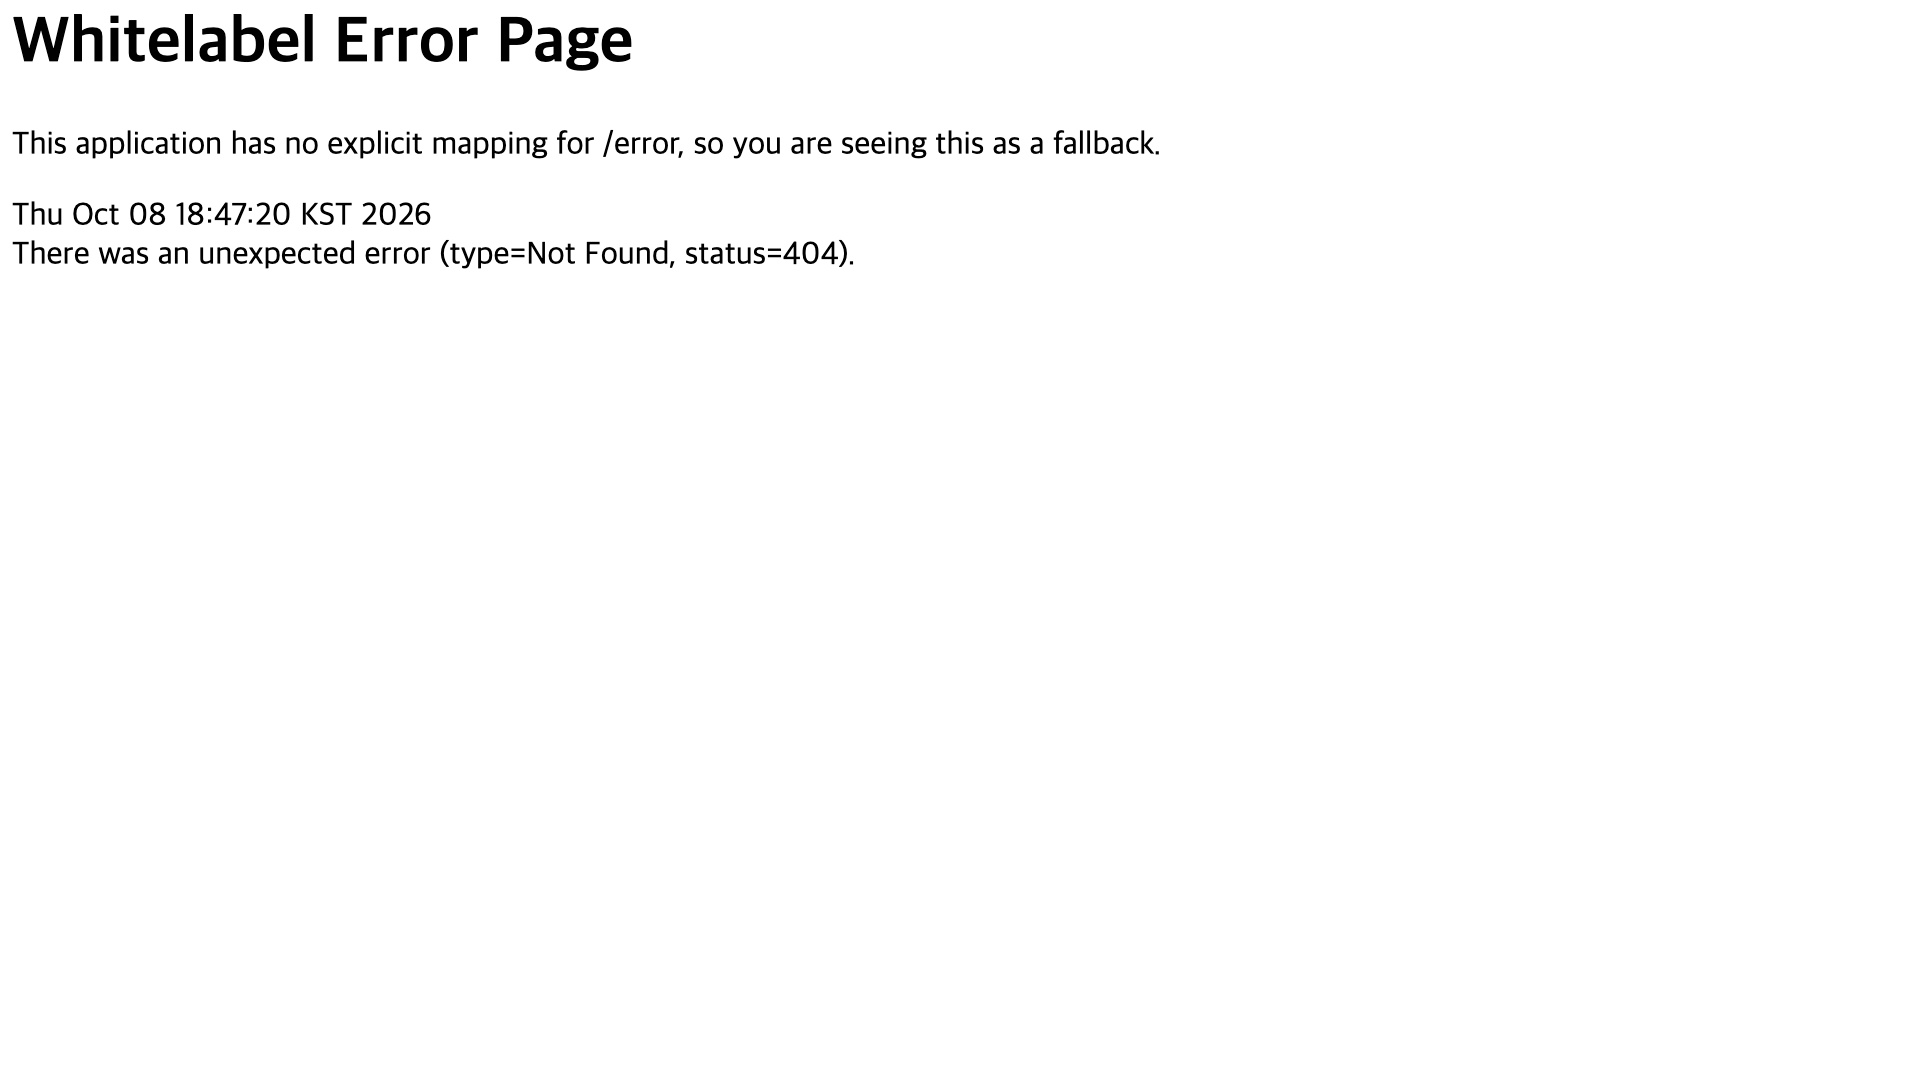
localhost:8080 접속 결과 — 오류처럼 보이지만 성공입니다
기술 도메인
위 화면은 오류처럼 생겼지만 서버는 정상 실행되었고, 우리 게시판이 루트(/)에 정적 페이지를 제공하지 않아 404가 난 것입니다. 마음에 안 들면 src/main/resources/static/index.html을 만들어 꾸미면 됩니다. 서버가 아예 안 떴다면 브라우저는 “연결할 수 없음”을 보여 줍니다.
@SpringBootApplication의 스캔 범위는 org.sopt와 하위 패키지이므로, 다른 최상위 패키지에 둔 클래스는 @Service를 붙여도 발견되지 않을 수 있습니다.
보완Boot 4.0.8은 세미나 자료의 실습 기준 버전입니다. 사용하는 JDK·Gradle이 선택한 Boot 버전과 호환되는지 공식 요구 사항을 확인하세요. 테스트 의존성도 Boot가 관리하는 버전을 따를지, 원문처럼 JUnit BOM을 명시할지 한 가지로 정하는 것이 좋습니다.
STEP 2Bean 등록과 생성자 주입
핵심각 계층 클래스에 @RestController · @Service · @Repository를 붙이고, 직접 new하던 연결을 생성자 주입으로 바꿉니다.
이론
계층별 어노테이션
Controller → @RestController, Service → @Service, Repository → @Repository. 그 밖에 Bean으로 등록할 클래스는 @Component만 붙이면 Component Scan으로 등록됩니다.
new 제거 → 생성자로 받기
Controller 안의 new PostService(), Service 안의 new PostRepository()를 지우고 각각 생성자 인자로 받습니다. Repository가 인터페이스라면 @Repository는 구현 클래스에 붙입니다.
콘솔 UI 걷어 내기
Scanner·System.out 기반 입출력은 Controller에서 제거하고, 요청 DTO와 응답 DTO로 바꿉니다. Post와 DTO는 요청마다 만들어지는 데이터 객체이므로 Bean으로 만들지 않습니다.
비유
직원(Bean)을 인사 명단에 등록하면, 회사(Container)가 각자에게 필요한 동료를 배정(주입)해 줍니다.
예시
// Controller
@RestController
public class PostController {
    private final PostService postService;          // 생성자 주입

    public PostController(PostService postService) {
        this.postService = postService;
    }
    ...
}

// Service
@Service
public class PostService {
    private final PostRepository postRepository;    // 생성자 주입

    public PostService(PostRepository postRepository) {
        this.postRepository = postRepository;
    }
    ...
}

// Repository
@Repository
public class PostRepository {
    // 원래 Bean은 상태를 가지면 안 되지만, 아직 DB가 없으니 여러 스레드가 공유하는 저장소로 활용
    private final Map<Long, Post> posts = new HashMap<>();
    ...
}
요청·응답 DTO
public record CreatePostRequest(String title, String content) {}
public record UpdatePostRequest(String title, String content) {}
public record PostResponse(Long id, String title, String content) {}
// Controller가 기대하는 Service 동작 (구현은 1차 과제에서 이관)// PostResponse create(CreatePostRequest request)// List<PostResponse> findAll(int page)// PostResponse findById(Long id)// PostResponse update(Long id, UpdatePostRequest request)// void delete(Long id)
기술 도메인
인메모리 Map은 서버를 재시작하면 사라지고, 여러 요청이 동시에 접근하므로 동시성 문제도 남아 있습니다(→ 5-3). DTO 선언만으로 공백·길이 검증이 적용되지는 않습니다. record는 JDK 16 이상에서 사용할 수 있습니다.
보완“상태 있는 Bean은 무조건 금지”는 아닙니다. 저장소의 Map은 의도된 공유 상태이고, 대신 별도의 동시성 설계가 필요합니다. 예제의 HashMap을 운영 환경에서 안전한 저장소로 간주하지 않습니다. (원문은 Map<Integer, Post>이지만 Controller의 Long postId와 맞추려면 키 타입을 통일하세요.)
클래스의 @RequestMapping("/api/v1/posts")와 메서드의 @GetMapping("/{postId}")가 합쳐져 최종 경로 /api/v1/posts/{postId}가 됩니다.
전용 어노테이션이 없는 메서드
Spring MVC에는 HEAD·OPTIONS·TRACE 전용 어노테이션이 없지만 @RequestMapping(method = RequestMethod.HEAD, path = "/posts")처럼 쓸 수 있습니다.
@Controller가 아니라 @RestController인 이유
과제로 직접 알아봅시다! (힌트: 6-3)
비유
하나의 “게시글 창구”(/api/v1/posts)에 조회 · 작성 · 수정 · 삭제 담당자를 각각 배치하고(매핑), 손님이 낸 서류에서 필요한 칸을 담당자 책상에 옮겨 주는 것(바인딩)입니다.
예시
완성된 PostController
@RestController
@RequestMapping("/api/v1/posts")
public class PostController {
    private final PostService service;

    public PostController(PostService service) {
        this.service = service;
    }

    @PostMapping                                         // POST /api/v1/posts
    public ResponseEntity<PostResponse> create(
            @RequestBody CreatePostRequest request) {
        PostResponse post = service.create(request);
        return ResponseEntity.created(
            URI.create("/api/v1/posts/" + post.id())).body(post);   // 201 + Location
    }

    @GetMapping                                          // GET /api/v1/posts?page=1
    public List<PostResponse> list(
            @RequestParam(name = "page", defaultValue = "1") int page) {
        return service.findAll(page);
    }

    @GetMapping("/{postId}")                             // GET /api/v1/posts/1
    public PostResponse get(@PathVariable("postId") Long id) {
        return service.findById(id);
    }

    @PutMapping("/{postId}")                             // PUT /api/v1/posts/1
    public PostResponse update(@PathVariable("postId") Long id,
            @RequestBody UpdatePostRequest request) {
        return service.update(id, request);
    }

    @DeleteMapping("/{postId}")                          // DELETE /api/v1/posts/1
    public ResponseEntity<Void> delete(@PathVariable("postId") Long id) {
        service.delete(id);
        return ResponseEntity.noContent().build();       // 204
    }
}
기술 도메인
생성은 201 + Location, 삭제는 204를 반환해 1-5의 상태 코드 규칙을 지킵니다. ResponseEntity는 org.springframework.http, URI는 java.net, List는 java.util, 매핑 어노테이션은 org.springframework.web.bind.annotation에서 import합니다. 경로 변수 이름을 명시하면(@PathVariable("postId")) 컴파일 옵션에 덜 의존합니다. page=0이나 음수는 int로 바인딩돼도 의미상 유효하지 않으므로 범위 검증이 필요합니다.
테이블
매핑 어노테이션
HTTP 메서드
전용 매핑 어노테이션
GET
@GetMapping
POST
@PostMapping
PUT
@PutMapping
PATCH
@PatchMapping
DELETE
@DeleteMapping
메서드 파라미터 바인딩 어노테이션
어노테이션
가져오는 데이터
예시
@RequestBody
HTTP Body
JSON
@PathVariable
URL 경로 변수
/posts/{id}
@RequestParam
Query Parameter
/posts?page=1
@RequestHeader
HTTP Header
Authorization
@CookieValue
Cookie
sessionId
@ModelAttribute
Query Parameter/Form 데이터
폼 객체
@RequestPart
Multipart 요청의 특정 Part
파일 업로드
매핑과 바인딩은 서로 다른 설정입니다
기능
매핑
파라미터·응답
생성
@PostMapping
@RequestBody CreatePostRequest → 201 + Location
목록
@GetMapping
@RequestParam(page, 기본값 1) → 목록
단건
@GetMapping("/{postId}")
@PathVariable postId → 단건 또는 404
전체 수정
@PutMapping("/{postId}")
경로 ID + @RequestBody UpdatePostRequest
일부 수정
@PatchMapping("/{postId}")
부분 변경 DTO·명세 필요
삭제
@DeleteMapping("/{postId}")
경로 ID → 204, 본문 없음
보완원문 예시를 그대로 붙여 넣기 전에 확인할 점: ① public public 오타, ② 수정(PUT) 메서드에 수정할 값을 받는 @RequestBody가 빠져 있음, ③ ApiResponse·DTO·Service 메서드는 프로젝트에서 직접 정의해야 하는 타입. 또 Spring의 RequestMethod에는 CONNECT가 없습니다.
STEP 4실행 확인과 다음 과제
핵심이제 기본적인 CRUD를 제공하는 서버를 만들 수 있습니다! 🥳 생성 → 조회 → 수정 → 삭제를 실제로 호출해 상태 코드와 본문을 확인하고, 남은 문제를 다음 과제로 가져갑니다.
이론
확인 순서
시작 로그에서 애플리케이션과 Tomcat이 정상 기동했는지 확인
POST로 게시글을 생성하고 응답의 id 또는 Location 기록
그 ID로 단건 조회 → 수정 → 재조회하여 값이 바뀌었는지 확인
삭제 응답이 204이고 본문이 없는지 확인
없는 ID · 잘못된 JSON · 숫자가 아닌 ID 요청의 응답도 확인
아직 남은 문제들
서버를 껐다 켜면 모든 데이터가 사라지는데 어떡하지? 영속성
저장소 Map에 생성·수정·삭제 요청이 동시에 오면 어떡하지? 동시성
예외가 발생하면 어떻게 응답을 반환하지? 예외 응답
검색 기능은 어떻게 만들지? 검색
이 문제들은 과제와 다음 세미나에서 다룹니다.
비유
가게 문이 열렸는지(서버 기동)만 보지 말고, 실제로 주문을 넣고 받아 보는(API 호출) 단계까지 확인합니다.
예시
curl로 CRUD 호출하기
# 생성 → 201 Created + Location
curl -i -X POST http://localhost:8080/api/v1/posts \
  -H 'Content-Type: application/json' \
  -d '{"title":"세미나 후기","content":"Spring 시작"}'

# 목록 / 단건 → 200 OK
curl -i 'http://localhost:8080/api/v1/posts?page=1'
curl -i http://localhost:8080/api/v1/posts/1

# 수정 → 200 OK
curl -i -X PUT http://localhost:8080/api/v1/posts/1 \
  -H 'Content-Type: application/json' \
  -d '{"title":"수정한 제목","content":"수정한 본문"}'

# 삭제 → 204 No Content
curl -i -X DELETE http://localhost:8080/api/v1/posts/1
Postman을 쓴다면 같은 요청을 컬렉션으로 저장해 두면 이후 과제에서도 재사용할 수 있습니다.
검색: keyword, page, size 등의 계약과 빈 결과·범위 검증을 정한 뒤 저장소 조회를 확장합니다.
스스로 설명해 보기: “같은 Service가 여러 요청을 처리해도 괜찮은 이유”, “@RequestBody의 JSON은 누가 변환하는가”, “세션을 쓰는 HTTP와 REST 무상태 제약의 차이”, “생성자 주입과 DIP의 차이”를 코드와 함께 말할 수 있는지 확인합니다.
테이블
단순 호출을 넘어서 결과를 검증하기
검증 요청
기대 결과
확인할 이유
POST 유효한 제목·본문
201 + 생성 ID·Location
실제로 자원이 생성되었는지
생성 ID로 GET
200 + 입력한 값
저장과 응답 변환 연결
같은 ID로 PUT 후 GET
200 + 수정한 값
도메인 변경·저장 확인
DELETE 후 GET
204 이후 404
삭제와 없음 응답 확인
GET /posts/abc (Long ID)
보통 400
Controller 전 타입 변환 실패
지원하지 않는 메서드
405
매핑 계약 확인
서버 재시작 후 조회
인메모리라면 데이터 소실
영속 저장 필요성 확인
보완위 표는 설계 목표입니다. Bean·매핑만 추가한 지금 단계에서는 “없는 게시글” 같은 예외가 아직 404로 변환되지 않고 500이 날 수 있습니다. 결과와 목표의 차이가 곧 다음 과제입니다. (원문의 피드백 이미지는 제공된 파일이 없어 포함하지 않았습니다.)
파트별 이해도 점검
3차 세미나 · 데이터베이스와 JPA
2차 세미나의 게시글 API는 서버를 재시작하면 데이터가 모두 사라졌습니다. 이번 주차는 데이터베이스의 기본 개념(RDB · SQL · 트랜잭션 · 인덱스)에서 출발해 JDBC → 커넥션 풀 → ORM → JPA로 이어지는 흐름을 따라가고, 마지막 실습에서 메모리 저장소를 MySQL + Spring Data JPA로 바꿉니다.
Map<Category, Set<Long>> index = new EnumMap<>(Category.class);

void save(Post post) {
    posts.put(post.getId(), post);
    index.computeIfAbsent(post.getCategory(), c -> new TreeSet<>())
         .add(post.getId());   // 저장 로직 증가 · 정렬은 TreeSet으로
}
기술 도메인
이 고민은 이번 주차의 DB 인덱스(1-14)와 그대로 이어집니다. 조회를 빠르게 하는 보조 자료구조를 두면 쓰기 시 함께 갱신해야 하는 비용과 정합성 관리가 따라옵니다. 수정 시 카테고리가 바뀌면 이전 카테고리 Set에서 제거해야 하고, 동시 접근 시 두 구조가 어긋나지 않게 해야 합니다.
보완게시글 수가 수백 개 수준이라면 단순 순회도 충분히 빠릅니다. “성능 문제가 생길 수 있다”는 가설은 데이터 규모와 조회 빈도를 함께 적어 두고, 가능하면 측정해서 비교하면 고민의 가치가 더 커집니다.
0-2코드 리뷰 작성
핵심학습 과정의 코드 리뷰는 고칠 점을 찾는 일이 아니라, 내 구현 기준을 단단하게 하고 시야를 넓히는 대화입니다.
이론
코드 리뷰는 낯설 수 있다
리드도 처음엔 그랬습니다. 학습 과정에서의 코드 리뷰는 단순히 문제를 찾아 고칠 점을 코멘트하는 과정이 아닙니다.
다른 사람의 과제를 보면서 남길 코멘트
“좋은 아이디어”, “잘 구현된 것”에 → “이 방법 좋은 것 같아요!”
“나와 다르게 구현된 것”, “다른 좋은 방법이 있는 구현”에 → “~와 같은 방법은 어떤가요?”
이런 코멘트는 과제를 하는 여러분의 구현 기준을 더 단단하게 만들고, 개발에 대한 시야를 넓혀 줍니다.
도움이 안 되는 리뷰
단순히 “수고하셨습니다!”, “잘 읽었습니다.”는 리뷰를 받는 사람과 리뷰어 모두에게 아무런 도움이 되지 않습니다.
리드의 당부
과제를 하면서 고민하지 않고 의견을 나누지 않으면 솝트에서 얻어갈 수 있는 것이 없습니다. 과제에 대한 세밀한 가이드를 미리 드리지 못해 죄송하다는 말과 함께 — 앞으로는 더 열린 자세로 과제를 해 주세요! 🥺
비유
스터디에서 서로의 풀이를 비교하는 것과 같습니다. “맞았네요”보다 “저는 이렇게 풀었는데 이 방법은 어때요?”가 두 사람 모두를 성장시킵니다.
예시
✗ 도움이 안 되는 코멘트
“수고하셨습니다!” “잘 읽었습니다.”
✓ 대화를 만드는 코멘트
“카테고리 인덱스를 따로 둔 아이디어 좋은 것 같아요! 수정 시 카테고리가 바뀌면 이전 인덱스에서도 제거되나요?” “여기서는 EnumMap을 쓰는 방법은 어떤가요?”
기술 도메인
GitHub PR 리뷰에서는 줄 단위 코멘트(Suggestion)로 구체적인 위치를 짚고, 근거(문서·측정·대안 코드)를 함께 남기면 좋습니다. 질문형 코멘트는 리뷰받는 사람이 스스로 설명하며 정리할 기회를 줍니다.
0-3Concurrent와 Atomic · CAS
핵심둘 다 멀티스레드 환경에서 안전하게 데이터를 다루는 도구지만, Concurrent는 공유 컬렉션, Atomic은 하나의 변수를 원자적으로 다룹니다. 공통적으로 내부에서 CAS를 활용합니다.
이론
해결하려는 문제가 다르다
Concurrent 계열: 여러 스레드가 공유하는 컬렉션이나 자료구조를 안전하게 사용하기 위한 도구
Atomic 계열: 하나의 변수에 대한 읽기·쓰기·수정 작업을 원자적으로 수행하기 위한 도구
레이스 컨디션이 생기는 흐름 (count++)
여러 스레드가 count를 동시에 읽음
같은 값을 읽고 1을 증가시킴
증가된 값을 반영
결국 여러 스레드가 동시에 count를 증가시켜도 1만 증가할 수 있습니다.
CAS(Compare-And-Set / Compare-And-Swap)
말 그대로 변경 전에 먼저 비교합니다. 단순히 값을 덮어쓰는 대신, 값이 내가 확인했던 상태 그대로인지 검증한 뒤 갱신합니다.
현재 count 조회
count에 1을 증가시킴
반영하기 전에 현재 count가 이전에 조회한 값과 같은지 확인
같다면 증가된 값을 반영
CAS는 3·4번(비교와 변경)을 하나의 원자적 연산으로 수행하기 때문에 다른 스레드의 영향을 받지 않고 레이스 컨디션을 해결합니다. incrementAndGet 같은 함수는 CAS 실패 시의 재시도까지 내부에서 처리합니다.
Concurrent 컬렉션은 조금 더 복잡하다
CAS뿐 아니라 synchronized 같은 방법과 조합되기도 하고, 버킷이라는 단위를 사용하기도 합니다. 더 다루기에는 길어지므로 아티클 주제로 남겨 둡니다. (누군가 작성해 주겠죠? ㅎㅎ)
비유
공유 문서를 고칠 때 “내가 열었을 때 버전이 v3였는데, 저장하려는 지금도 v3이면 저장, 아니면 다시 열어서 고친다” — 이것이 CAS입니다. 확인과 저장을 한 동작으로 처리합니다.
예시
// count++와 동일
AtomicLong viewCount = new AtomicLong(0);
viewCount.incrementAndGet();
// 개념적으로 incrementAndGet이 하는 일
long prev, next;
do {
prev = viewCount.get(); // 1. 현재 값 조회
next = prev + 1; // 2. 증가
} while (!viewCount.compareAndSet(prev, next)); // 3·4. 비교+변경 (실패 시 재시도)// 공유 컬렉션은 Concurrent 계열로
Map<Long, Post> posts = new ConcurrentHashMap<>();
기술 도메인
게시글 ID 발급(AtomicLong), 조회수 증가, 메모리 저장소(ConcurrentHashMap)에 바로 쓰입니다. 다만 여러 단계로 구성된 복합 동작(“게시글 저장 + 카테고리 인덱스 갱신”)은 각 단계가 원자적이어도 전체가 원자적이지 않으므로, 다음 단계인 DB 트랜잭션(1-13)이나 락이 필요합니다.
보완“위 계열은 모두 내부적으로 CAS를 사용한다”는 대부분에 해당하는 설명입니다. 예를 들어 CopyOnWriteArrayList는 쓰기 시 락을 잡고 배열을 복사하는 방식이며, ConcurrentHashMap은 빈 버킷에는 CAS, 충돌한 버킷에는 synchronized를 씁니다. 또 ConcurrentHashMap에서 get 후 put처럼 나눠 호출하면 원자적이지 않으므로 compute/merge/putIfAbsent를 사용합니다.
01데이터베이스
2차 세미나의 게시글은 JVM Heap에 있어서 서버를 재시작하면 전부 사라졌습니다. 데이터를 프로세스보다 오래 살아남게 하는 방법, 데이터베이스를 알아봅니다. (MySQL 기준)
1-1영속성과 파일 저장의 한계
핵심서버가 다루는 데이터는 프로세스보다 오래 살아남아야 합니다(영속성, Persistence). 파일 저장은 가장 단순하지만 서버 환경의 동시성·정합성·검색 문제를 감당하기 어렵습니다.
이론
메모리 저장소의 두 가지 문제
객체는 JVM의 Heap에 있고, Heap은 프로세스가 종료되면 함께 사라집니다 → 서버를 재시작하면 작성한 게시글이 전부 사라짐.
데이터가 쌓일수록 서버가 비즈니스 로직 실행에 쓸 수 있는 메모리가 줄어들어, 결국 서버가 동작하지 못할 수 있습니다.
영속성(Persistence)
데이터를 영구적으로 보존하는 성질입니다. 서버가 다루는 데이터는 프로세스보다 오래 살아남아야 합니다.
파일 저장의 한계
가장 단순한 방법은 파일에 저장하는 것이지만 서버 환경에서는 곧 한계에 부딪힙니다(동시성 · 정합성 · 검색 성능 · 중복과 불일치 · 보안 → 테이블 참고). 1차 세미나에서 이야기한 서버의 역할인 중앙 관리와 공유·동시성 제어를 파일로 직접 구현하는 것은 너무 어렵습니다.
비유
메모리 저장소는 화이트보드입니다. 회의(프로세스)가 끝나면 지워지고, 보드가 꽉 차면 더 쓸 공간이 없습니다. 파일은 공책이지만 여러 명이 동시에 같은 페이지에 쓰면 글씨가 겹칩니다.
예시
// 2차 세미나의 메모리 저장소 — 재시작하면 사라진다
private final Map<Long, Post> store = new HashMap<>();
// 파일로 저장한다면? 두 스레드가 동시에 쓰면 내용이 깨질 수 있고,// "작성자가 경민인 글"을 찾으려면 파일 전체를 읽어야 한다
Files.writeString(Path.of("posts.csv"), line, StandardOpenOption.APPEND);
기술 도메인
이 문제들을 해결하는 소프트웨어가 DBMS입니다(1-2). 이번 실습(6장)에서는 메모리 저장소를 MySQL로 바꿔 재시작 후에도 게시글이 남도록 만듭니다.
테이블
파일 저장의 한계
문제
상황
동시성
두 스레드가 동시에 같은 파일을 쓰면 내용이 깨짐
정합성
쓰는 도중 서버가 죽으면 파일이 반쯤 저장된 상태로 남음
검색 성능
"작성자가 경민인 글"을 찾으려면 파일 전체를 읽어야 함
중복과 불일치
같은 데이터가 여러 파일에 흩어지면 하나만 수정되는 문제 발생
보안
파일 단위로만 권한 관리 가능
1-2DB와 DBMS
핵심데이터베이스는 여러 사용자와 프로그램이 공유할 수 있도록 통합·저장된 구조화된 데이터의 집합이고, DBMS는 그 데이터를 관리하는 소프트웨어입니다.
이론
정의
DB — 데이터 그 자체 (창고에 쌓인 물건)
DBMS(Database Management System) — 데이터를 저장·조회·수정하고, 동시 접근과 장애를 관리하는 프로그램 (창고 관리 시스템). 예: MySQL, PostgreSQL, Oracle, MongoDB, Redis
DBMS가 대신 해결해 주는 것
동시성 제어 — 락과 트랜잭션으로 동시에 접근해도 데이터가 깨지지 않음
장애 복구 — 로그를 이용해 서버가 죽어도 커밋된 데이터는 보존
빠른 검색 — 인덱스로 전체를 읽지 않고 원하는 데이터만 조회
무결성 보장 — 제약 조건으로 잘못된 데이터가 들어오는 것을 차단
비유
DB는 창고에 쌓인 물건, DBMS는 창고 관리 시스템입니다. 입출고 기록(로그), 출입 통제(락), 위치 색인(인덱스), 반입 규칙(제약 조건)을 시스템이 맡습니다.
예시
-- 무결성: 제약 조건이 잘못된 데이터를 막는다
INSERT INTO member (name, email, part) VALUES (NULL, 'a@sopt.org', 'SERVER');
-- ERROR 1048: Column 'name' cannot be null
기술 도메인
MySQL(InnoDB)은 redo/undo 로그로 장애 복구와 롤백을, B+Tree 인덱스로 검색을, 행 단위 락 + MVCC로 동시성을 처리합니다. 애플리케이션 코드는 이 기능들을 SQL과 트랜잭션 경계로 사용합니다.
1-3RDB와 NoSQL · DB 선택 기준
핵심DB는 관계형 여부, 데이터 모델, 라이선스, 저장 방식 등으로 분류됩니다. 대부분의 서비스는 핵심 데이터는 RDB, 캐시·세션은 Redis 같은 NoSQL에 나눠 저장합니다.
이론
분류 기준은 하나가 아니다
관계형(RDB)인지 여부뿐 아니라, 데이터 모델링 방식에 따라 문서 지향 · 키-값 · 그래프 DB로, 라이선스에 따라 오픈소스 · 상용으로, 저장 방식에 따라 디스크 기반 · 인메모리 DB로 나눕니다.
어떤 DB를 선택할까?
1차 세미나의 “무엇을 우선시할 것인가”와 같은 질문입니다. 위의 분류 기준과 특성에 따라 프로젝트에 적합한 DB를 고릅니다.
서비스의 데이터 구조: 정형화된 테이블·JOIN이 필요 → RDBMS / JSON 기반 유연한 구조·빠른 개발 → MongoDB
처리량 및 성능: 읽기/쓰기 속도가 중요 → Redis(인메모리) / 트랜잭션 정합성이 중요 → PostgreSQL, Oracle
확장성 및 분산 처리: 글로벌 서비스 → 분산형 NoSQL(MongoDB, Cassandra 등) / 수평 확장이 쉬운 구조 → Redis, MongoDB
기술 스택 및 팀 경험: SQL 경험이 풍부 → MySQL, PostgreSQL / Java·Spring 연동 → JDBC 드라이버·커뮤니티 존재 여부 확인
비용 및 라이선스: 예산 제한 → 오픈소스(MySQL, PostgreSQL, MongoDB) / 기술 지원이 중요 → 상용(Oracle, MS SQL Server)
이번 세미나의 기준
가장 많이 사용되는 RDB, 그중에서도 MySQL을 기준으로 알아봅니다.
비유
RDB는 칸이 정해진 엑셀 장부, 문서형 NoSQL은 자유 양식 메모 폴더, Redis는 책상 위 포스트잇(빠르지만 오래 보관용은 아님)입니다. 가계부(결제)는 장부에, 임시 메모(세션)는 포스트잇에 씁니다.
예시
-- RDB: 고정 스키마의 행
| id | name   | email       | part   |
| 1  | 박경민 | km@sopt.org | SERVER |

// MongoDB: 문서 하나에 중첩 저장
{ "_id": 1, "name": "박경민", "posts": [ { "title": "2차 세미나 후기" } ] }

# Redis: Key-Value
SET session:abc123 "memberId=1" EX 1800
기술 도메인
Spring 생태계에서는 RDB에 Spring Data JPA, Redis에 Spring Data Redis, MongoDB에 Spring Data MongoDB를 쓰며, 같은 Repository 추상화로 저장소를 나눠 쓸 수 있습니다.
테이블
RDB와 NoSQL
구분
RDB (관계형)
NoSQL
데이터 구조
테이블(행과 열), 고정된 스키마
문서, Key-Value, 그래프 등 유연한 구조
관계 표현
외래키와 JOIN
데이터를 중첩하거나 중복 저장
정합성
강한 정합성 (ACID)
가용성·확장성을 위해 완화하는 경우 많음
확장
주로 수직 확장(Scale-up)
수평 확장(Scale-out)에 유리
예시
MySQL, PostgreSQL, Oracle
MongoDB(문서), Redis(Key-Value), Neo4j(그래프)
적합한 곳
결제, 주문, 회원 등 정합성이 중요한 핵심 데이터
캐시, 세션, 로그, 구조가 자주 바뀌는 데이터
주류 DBMS
DBMS
분류
특징
MySQL
관계형 / 오픈소스 / 디스크 기반
가장 널리 사용되는 오픈소스 RDB, 커뮤니티와 생태계 풍부
PostgreSQL
관계형 / 오픈소스 / 디스크 기반
기능이 강력하고 표준 SQL 준수, 고급 쿼리 지원
Oracle DB
관계형 / 상용 / 디스크 기반
대기업에서 많이 사용, 안정성과 기술지원 강점
MongoDB
문서 지향 / 오픈소스(SSPL) / 디스크 기반
유연한 스키마, JSON 기반 문서 저장
Redis
Key-Value / 오픈소스 / 인메모리
빠른 속도의 캐시 및 세션 저장용으로 적합
보완표의 구분은 경향입니다. RDB도 읽기 복제본·샤딩으로 수평 확장할 수 있고, MongoDB도 다중 문서 트랜잭션을 지원합니다. 또 MongoDB의 SSPL과 Redis의 최근 라이선스는 OSI 기준의 “오픈소스”와는 차이가 있어 소스 공개(source-available)로 구분하기도 합니다.
1-4테이블 · 행 · 열 · 스키마
핵심관계형 DB는 데이터를 테이블에 저장하고, 스키마가 먼저 정해진 뒤 데이터가 그 스키마를 따라야 합니다.
이론
테이블의 구성
테이블은 같은 종류의 데이터 묶음이고, 행(Row)은 데이터 하나(회원 한 명), 열(Column)은 데이터의 속성(이름, 이메일)입니다. 스키마는 열 이름·타입·제약 조건 같은 테이블의 구조 정의입니다.
스키마 우선
RDB는 스키마가 먼저 정해지고 데이터는 그 스키마를 따라야 합니다. 예를 들어 age 열이 bigint라면 문자열을 넣을 수 없습니다.
비유
테이블은 양식이 정해진 명부입니다. 머리글(열)이 먼저 인쇄되어 있고, 한 줄(행)에 한 사람씩 양식에 맞춰 적습니다.
예시
member 테이블
id
name
email
part
1
박경민
km@sopt.org
SERVER
2
김솝트
sopt@sopt.org
iOS
기술 도메인
JPA에서는 클래스 하나가 테이블, 필드가 열, 객체 인스턴스가 행에 대응합니다(4-1). 스키마 우선 특성 때문에 엔티티 필드를 바꾸면 테이블 구조 변경(DDL)도 함께 관리해야 합니다.
테이블
용어 정리
용어
의미
다른 이름
테이블
같은 종류의 데이터 묶음
릴레이션(Relation)
행(Row)
데이터 하나 (회원 한 명)
레코드, 튜플
열(Column)
데이터의 속성 (이름, 이메일)
필드, 속성(Attribute)
스키마(Schema)
테이블의 구조 정의 (열 이름, 타입, 제약 조건)
-
1-5키 · 자연키 vs 대리키
핵심행을 구분하고 테이블끼리 연결하기 위해 키를 씁니다. 비즈니스 규칙은 언젠가 바뀌므로 PK는 대리키를 권장합니다.
이론
세 가지 키
기본키(PK): 행을 유일하게 식별하는 값. NULL 불가, 중복 불가
외래키(FK): 다른 테이블의 PK를 참조하는 값. 테이블 간 관계를 표현
유니크 키(UK): 중복을 허용하지 않는 값 (이메일 등)
PK · FK · UK가 표시된 MEMBER–POST 관계
자연키 vs 대리키
자연키는 비즈니스적으로 의미 있는 이미 존재하는 값(주민등록번호, 이메일), 대리키는 비즈니스와 무관하게 만들어야 하는 값(자동 증가 숫자, UUID, TSID)입니다.
PK는 대리키를 권장
비즈니스 규칙은 언젠가 반드시 바뀝니다. 주민등록번호를 PK로 썼다가 개인정보 보호법이 바뀌면, 그 PK를 참조하는 모든 테이블을 수정해야 합니다.
자연키는 비즈니스 로직과 연관된 경우가 많아 정책에 따라 키로 쓸 수 없게 되기도 합니다. 예: 전화번호를 PK로 쓰다가 중복 회원가입이 가능해지면, 전화번호에 중복이 허용되면서 더 이상 키가 될 수 없습니다.
비유
자연키는 이름표에 적힌 이름(바뀌거나 겹칠 수 있음), 대리키는 사물함 번호(의미는 없지만 절대 겹치지 않고 바뀌지 않음)입니다.
예시
CREATE TABLE member (
    id    BIGINT AUTO_INCREMENT PRIMARY KEY,   -- 대리키 PK
    email VARCHAR(100) NOT NULL UNIQUE         -- 자연키는 UK로만
);
CREATE TABLE post (
    id        BIGINT AUTO_INCREMENT PRIMARY KEY,
    member_id BIGINT NOT NULL,
    FOREIGN KEY (member_id) REFERENCES member (id)   -- FK
);
기술 도메인
이메일처럼 의미 있는 값은 PK 대신 UNIQUE 제약으로 중복을 막고, PK는 대리키로 둡니다. 그러면 이메일 변경 기능이 생겨도 FK를 가진 다른 테이블은 영향을 받지 않습니다.
테이블
키의 종류
키
의미
기본키 (Primary Key, PK)
행을 유일하게 식별하는 값. NULL 불가, 중복 불가
외래키 (Foreign Key, FK)
다른 테이블의 PK를 참조하는 값. 테이블 간 관계를 표현
유니크 키 (Unique Key)
중복을 허용하지 않는 값 (이메일 등)
자연키 vs 대리키
구분
자연키 (Natural Key)
대리키 (Surrogate Key)
정의
비즈니스적으로 의미 있는 값, 이미 존재하는 값
비즈니스와 무관한 임의의 값, 만들어야 하는 값
예시
주민등록번호, 이메일
자동 증가 숫자(1, 2, 3...), UUID, TSID
문제
정책이 바뀌면 PK가 바뀜 (이메일 변경 가능?)
의미가 없어 직관성이 떨어짐
1-6연관관계 1:N (일대다)
핵심1:N 연관관계에서 외래키는 항상 N쪽 테이블에 존재합니다. 회원 한 명이 여러 게시글을 쓰면 post.member_id가 member.id를 참조합니다.
이론
가장 흔한 연관관계
테이블은 외래키를 통해 서로 관계를 맺고, 그중 1:N이 가장 흔합니다. 회원 한 명은 여러 게시글을 쓸 수 있으므로 post 테이블이 member 테이블의 PK를 member_id라는 FK로 참조합니다.
N쪽(POST)에 FK를 둔 정상 구조 — 회원 레코드는 하나
1쪽에 FK를 두면?
1쪽에서도 외래키로 관계를 표현할 수는 있습니다. 하지만 post의 각 레코드가 member_id만 추가로 알면 되는 경우와 달리, member 테이블에 작성한 게시글 수만큼 중복 레코드가 생깁니다.
1쪽(MEMBER)에 FK를 둔 잘못된 구조 — 회원 정보 중복
1쪽 FK의 문제
“경민” 회원 정보가 중복으로 존재합니다.
id가 중복되므로 PK로 사용할 수 없고, email 같은 컬럼에도 Unique 제약 조건을 쓸 수 없습니다.
회원 정보 수정 기능이 있다면 여러 레코드를 모두 수정해야 합니다.
⚠️ 따라서 일대다 관계에서는 일반적으로 N쪽 테이블에 FK를 두어, 하나의 회원 레코드를 여러 게시글 레코드가 참조하도록 설계합니다.
비유
학생(N)이 각자 담임 선생님 이름(FK)을 학생증에 적는 것은 자연스럽지만, 선생님(1)이 학생 수만큼 자기 명함을 복사해 학생 이름을 하나씩 적는 것은 낭비이고 수정도 어렵습니다.
예시
-- 경민(id=1)이 쓴 게시글 조회: N쪽 FK로 바로 필터
SELECT id, title FROM post WHERE member_id = 1;
기술 도메인
JPA에서도 같은 원칙이 적용되어 FK를 가진 N쪽 엔티티에 @ManyToOne을 둡니다(4-6, 4-7). 그래서 연관관계의 주인은 보통 N쪽입니다.
1-7연관관계 1:1 (일대일)
핵심1:1에서는 FK를 어느 쪽에 두어도 되지만, 두 데이터 간의 종속관계와 생명주기에 따라 결정합니다.
이론
한쪽에 하나만 대응
회원과 회원 상세 정보(프로필)처럼 한쪽에 하나만 대응되는 관계입니다.
MEMBER ↔ MEMBER_PROFILE (FK는 프로필 쪽, UK로 1:1 보장)
종속성 관점
프로필은 특정 회원에 종속된 데이터이므로, 회원 데이터 없이 독립적으로 존재할 수 없습니다.
생명주기 관점
회원은 회원가입 시 생성되지만 프로필은 이후 설정 과정에서 생성될 수 있으므로, 회원만 있고 프로필은 없는 상태가 가능합니다.
결론
member_profile 테이블에 회원을 참조하는 FK를 두면, member는 프로필 설정 여부와 관계없이 생성할 수 있고 프로필은 특정 회원과 연결해 관리할 수 있습니다.
비유
여권(프로필)에는 주인(회원)의 주민번호가 적혀 있지만, 사람이 태어날 때 여권이 함께 생기지는 않습니다. 나중에 발급되는 쪽이 원본을 가리키는 것이 자연스럽습니다.
예시
CREATE TABLE member_profile (
    id            BIGINT AUTO_INCREMENT PRIMARY KEY,
    member_id     BIGINT NOT NULL UNIQUE,     -- FK + UK → 회원당 프로필 1개
    introduction  VARCHAR(255),
    profile_image VARCHAR(255),
    FOREIGN KEY (member_id) REFERENCES member (id)
);
기술 도메인
FK 컬럼에 UNIQUE를 걸지 않으면 DB 입장에서는 1:N과 구분되지 않습니다. JPA에서는 @OneToOne + @JoinColumn(unique = true)로 표현합니다.
1-8연관관계 N:M · 중간 테이블
핵심RDB의 칸은 하나의 값만 가질 수 있어 N:M을 직접 표현할 수 없습니다. 두 테이블의 FK만 저장하는 중간 테이블로 1:N + N:1로 풀어냅니다.
이론
다대다 관계
회원은 여러 게시글에 좋아요를 누를 수 있고, 게시글도 여러 회원에게 좋아요를 받을 수 있습니다. 두 테이블이 서로 연관된 레코드를 여러 개 가질 수 있는 상황이 다대다입니다.
MEMBER ↔ POST 다대다 (테이블만으로는 표현 불가)
왜 직접 표현할 수 없나
RDB에서 각 행과 컬럼은 원자적인 값(atomic value), 즉 하나의 값만 가질 수 있어 FK가 참조할 수 있는 레코드는 하나로 제한됩니다. post와 member가 FK로 가질 member_id, post_id는 “1, 2, 3, …”처럼 여러 값을 가질 수 없습니다.
중간 테이블
FK만 저장하는 테이블을 양쪽에서 일대다로 참조하게 하여 해결합니다. 다대다 관계의 중간에 위치한다고 해서 중간 테이블이라 부릅니다.
POST_LIKE 중간 테이블로 풀어낸 N:M
중간 테이블의 컬럼과 PK
보통 양쪽 테이블의 PK에 해당하는 값만 FK로 두지만, 필요하면 created_at처럼 비즈니스 로직에 필요한 컬럼도 둡니다.
PK는 FK들의 묶음을 복합키로 쓰기도 하고, 독립적으로 사용하거나 다른 테이블에서 참조하는 경우에는 대리키를 별도로 만들어 PK로 씁니다.
좋아요처럼 조합이 간단하고 단순히 연결 역할만 하면 복합키, 확장 가능성이 있고 레코드를 독립적으로 조회·참조한다면 대리키를 사용합니다.
비유
학생과 수업은 다대다지만, 학생증에도 수업 목록에도 상대를 전부 적지 않고 수강 신청서(학생 번호 + 수업 번호) 한 장씩을 따로 보관합니다. 신청 일시 같은 정보도 신청서에 적을 수 있습니다.
예시
-- 복합키 방식
CREATE TABLE post_like (
    member_id BIGINT NOT NULL,
    post_id   BIGINT NOT NULL,
    PRIMARY KEY (member_id, post_id),
    FOREIGN KEY (member_id) REFERENCES member (id),
    FOREIGN KEY (post_id)   REFERENCES post (id)
);

-- 1번 게시글에 좋아요를 누른 회원
SELECT m.nickname FROM post_like pl JOIN member m ON pl.member_id = m.id
WHERE pl.post_id = 1;
기술 도메인
JPA에서는 @ManyToMany 대신 중간 테이블을 연결 엔티티(PostLike)로 만들어 두 개의 @ManyToOne으로 매핑하는 방식이 권장됩니다(4-8). 대리키를 쓰더라도 (member_id, post_id)에 복합 유니크 제약을 걸어 중복 좋아요를 막습니다.
1-9정규화와 반정규화
핵심정규화는 중복을 제거하고 데이터를 논리적 단위로 분리하는 과정이고, 반정규화는 성능을 위해 의도적으로 중복을 허용하는 것입니다.
이론
정규화 전 — 모든 정보를 한 테이블에
게시글 행마다 작성자 이름·이메일을 함께 저장하면 이상 현상(Anomaly)이 생깁니다 — 갱신 이상, 삽입 이상, 삭제 이상(테이블 참고).
해결
회원 정보는 member 테이블로 분리하고, 게시글은 member_id로 참조하면 해결됩니다. 앞의 연관관계(1-6) 구조가 바로 정규화된 결과입니다.
정규형 (간단히)
1NF: 한 칸에는 하나의 값만
2NF: 기본키 전체에 의존하지 않는 열을 분리
3NF: 기본키가 아닌 열에 의존하는 열을 분리
1차 세미나의 SRP(단일 책임 원칙)와 닮았습니다. “변경되어야 할 이유가 하나뿐”이도록 데이터를 나누는 것입니다.
반정규화(Denormalization)
정규화를 할수록 테이블이 쪼개져 조회 시 JOIN이 많아지고 느려집니다. 그래서 성능을 위해 의도적으로 중복을 허용하기도 합니다.
예시: 게시글 목록마다 댓글 수를 보여 줘야 한다면, 매번 COUNT하지 않고 post.comment_count 열을 둡니다.
대가: 댓글이 추가·삭제될 때마다 comment_count도 함께 갱신해야 하며, 실제 댓글 수와 달라질 수 있습니다. (정합성 관리 비용)
비유
정규화는 연락처를 주소록 한 곳에만 적고 다른 문서에서는 “주소록 3번”이라고 가리키는 것, 반정규화는 자주 보는 문서에 전화번호를 복사해 두는 것입니다. 빠르지만 번호가 바뀌면 복사본도 고쳐야 합니다.
예시
정규화 전 — 모든 정보를 한 테이블에
post_id
title
member_name
member_email
member_id
1
2차 세미나 후기
박경민
km@sopt.org
1
2
JPA 어려워요
박경민
km@sopt.org
1
-- 반정규화: 댓글 추가 시 카운트도 함께 갱신 (같은 트랜잭션으로)
INSERT INTO comment (post_id, content) VALUES (1, '좋아요');
UPDATE post SET comment_count = comment_count + 1 WHERE id = 1;
기술 도메인
JPA 엔티티 설계도 정규화된 테이블을 기준으로 합니다. 반정규화 컬럼은 변경 지점을 한 곳(도메인 메서드나 Service)에 모으고, 동시성 때문에 카운트가 어긋나지 않도록 UPDATE ... SET c = c + 1 같은 원자적 갱신이나 락(5-9)을 고려합니다.
테이블
이상 현상 (Anomaly)
이상 현상
상황
갱신 이상
경민의 이메일이 바뀌면 모든 게시글 행을 수정해야 하고, 하나라도 빠뜨리면 데이터가 불일치
삽입 이상
게시글을 안 쓴 회원은 저장할 방법이 없음
삭제 이상
경민의 게시글을 모두 지우면 경민의 회원 정보도 함께 사라짐
정규형
정규형
규칙 (간단히)
1NF
한 칸에는 하나의 값만 ("Java, Spring" 같은 다중 값 금지)
2NF
기본키 전체에 의존하지 않는 열을 분리 (복합키의 일부에만 의존하는 열 제거)
3NF
기본키가 아닌 열에 의존하는 열을 분리 (member_name이 member_id에 의존 → 분리)
보완원문의 반정규화 대가 설명 중 “실제 좋아요 수와 달라질 수 있습니다”는 예시가 댓글 수이므로 “실제 댓글 수”로 고쳐 적었습니다.
1-10SQL 분류와 DDL
핵심SQL은 RDB에 명령을 내리는 언어이고, 목적에 따라 DDL · DML · DCL · TCL로 나눕니다. DDL은 테이블 생성·변경·삭제 같은 구조를 정의합니다.
이론
SQL(Structured Query Language)
RDB에 명령을 내리기 위한 언어입니다. 구조 정의(DDL), 데이터 조작(DML), 권한 관리(DCL), 트랜잭션 제어(TCL)로 나뉩니다.
DDL은 명부 양식을 인쇄·수정하는 일, DML은 명부에 이름을 적고 지우는 일, DCL은 명부 열람 권한을 주는 일, TCL은 “여기까지 확정” 도장을 찍는 일입니다.
예시
-- member 테이블 생성
CREATE TABLE member (
    id      BIGINT       AUTO_INCREMENT PRIMARY KEY,
    name    VARCHAR(20)  NOT NULL,
    email   VARCHAR(100) NOT NULL UNIQUE,
    part    VARCHAR(10)  NOT NULL
);

-- member 테이블에 age 컬럼 추가
ALTER TABLE member
ADD COLUMN age INT;

-- post 테이블 생성
CREATE TABLE post (
    id         BIGINT       AUTO_INCREMENT PRIMARY KEY,
    title      VARCHAR(100) NOT NULL,
    content    TEXT         NOT NULL,
    member_id  BIGINT       NOT NULL,
    created_at DATETIME     NOT NULL,
    FOREIGN KEY (member_id) REFERENCES member (id)
);
기술 도메인
실습에서는 ddl-auto: update로 Hibernate가 DDL을 자동 생성하지만(6장), 운영 환경에서는 의도치 않은 변경을 막기 위해 DDL을 직접 작성하고 Flyway·Liquibase 같은 마이그레이션 도구로 버전 관리합니다.
테이블
SQL의 분류
분류
의미
명령어
DDL (Definition)
스키마(구조) 정의
CREATE, ALTER, DROP
DML (Manipulation)
데이터 조작
SELECT, INSERT, UPDATE, DELETE
DCL (Control)
권한 관리
GRANT, REVOKE
TCL (Transaction Control)
트랜잭션 제어
COMMIT, ROLLBACK
보완MySQL에서 DDL은 실행 시 암묵적으로 커밋됩니다. 트랜잭션 안에서 ALTER TABLE을 실행하면 그 전까지의 변경도 함께 확정되어 롤백할 수 없습니다.
1-11DML · CRUD
핵심CRUD는 각각 INSERT · SELECT · UPDATE · DELETE에 대응합니다. UPDATE·DELETE에서 WHERE를 빠뜨리면 테이블 전체가 바뀝니다.
UPDATE, DELETE에서 WHERE를 빠뜨리면 테이블 전체가 바뀝니다. 조건을 빠트리고 사용하면 큰 사고가 발생할 수 있습니다!
비유
“3번 사물함 비워 주세요”를 “사물함 비워 주세요”라고만 말하면 모든 사물함이 비워집니다. WHERE는 대상 사물함 번호입니다.
예시
-- Create
INSERT INTO post (title, content, member_id, created_at)
VALUES ('3차 세미나 후기', 'JPA 재밌다', 1, NOW());

-- Read
SELECT id, title FROM post WHERE member_id = 1 ORDER BY created_at DESC;

-- Update
UPDATE post SET title = '수정된 제목' WHERE id = 1;

-- Delete
DELETE FROM post WHERE id = 1;
기술 도메인
MySQL 클라이언트에는 키 조건 없는 UPDATE/DELETE를 막는 SET SQL_SAFE_UPDATES = 1;(Workbench 기본 활성) 옵션이 있습니다. 운영 DB에서 수동 쿼리를 실행할 때는 먼저 같은 조건으로 SELECT해 영향 범위를 확인하고 트랜잭션 안에서 실행하는 습관이 안전합니다.
테이블
CRUD ↔ SQL
CRUD
SQL
Create
INSERT
Read
SELECT
Update
UPDATE
Delete
DELETE
1-12JOIN
핵심정규화로 나눈 테이블을 다시 합쳐서 조회할 때 JOIN을 씁니다. INNER는 양쪽 모두 매칭되는 행만, LEFT/RIGHT는 한쪽 테이블의 모든 행을 남깁니다.
이론
JOIN의 종류
INNER JOIN: 양쪽 테이블에 모두 매칭되는 행만 — 게시글을 작성하지 않은 사용자는 조회되지 않음
LEFT (OUTER) JOIN: 왼쪽 테이블의 모든 행 + 매칭되는 오른쪽 행 (없으면 NULL)
RIGHT (OUTER) JOIN: LEFT JOIN의 반대
LEFT와 RIGHT는 순서만 바꾸면 같다
LEFT JOIN과 RIGHT JOIN은 테이블의 순서만 변경하면 서로 뒤바뀔 수 있습니다.
비유
반 명단(member)과 제출물(post)을 맞춰 볼 때, INNER는 제출한 학생만, LEFT는 전체 명단에 제출물을 옆에 붙이고 미제출은 빈칸으로 둔 표입니다.
예시
-- 게시글과 작성자 이름을 함께 조회, 게시글을 작성하지 않은 사용자는 조회되지 않음
SELECT p.id, p.title, m.name
FROM post p
INNER JOIN member m ON p.member_id = m.id;

-- 게시글을 하나도 안 쓴 회원까지 포함해 조회하려면? → LEFT JOIN
SELECT m.name, p.title
FROM member m
LEFT JOIN post p ON m.id = p.member_id;

-- 회원 정보가 없는 게시글까지 포함해 조회 → RIGHT JOIN
SELECT m.name, p.title
FROM member m
RIGHT JOIN post p ON m.id = p.member_id;
기술 도메인
JPA의 FETCH JOIN(5-8)은 기본이 INNER JOIN이고, @EntityGraph는 LEFT OUTER JOIN으로 변환됩니다. 어떤 JOIN이 나가는지에 따라 연관 데이터가 없는 행이 결과에서 빠질 수 있으니 SQL 로그로 확인합니다.
테이블
JOIN 종류
JOIN
결과
INNER JOIN
양쪽 테이블에 모두 매칭되는 행만
LEFT (OUTER) JOIN
왼쪽 테이블의 모든 행 + 매칭되는 오른쪽 행 (없으면 NULL)
RIGHT (OUTER) JOIN
LEFT JOIN의 반대
보완원문의 RIGHT JOIN 예시처럼 “회원 정보가 없는 게시글”은 post.member_id가 NOT NULL + FK인 스키마(1-10)에서는 생기지 않습니다. RIGHT JOIN은 member_id가 NULL을 허용하거나 FK 제약이 없을 때 의미가 있습니다.
1-13트랜잭션과 ACID
핵심트랜잭션은 더 이상 쪼갤 수 없는 하나의 논리적인 작업 단위입니다. 묶인 작업은 모두 성공하거나 모두 실패해야 하며, ACID 네 가지 성질을 보장합니다.
이론
계좌 이체 문제
A 계좌에서 출금한 직후 서버가 죽으면, A의 돈은 빠져나갔는데 B에게는 들어오지 않아 1만 원이 증발합니다. 두 작업은 모두 성공하거나 모두 실패해야 하고, 이렇게 묶는 단위가 트랜잭션입니다.
ACID
원자성(Atomicity): 전부 성공하거나 전부 실패
일관성(Consistency): 트랜잭션 전후로 데이터가 규칙(제약 조건)을 만족
격리성(Isolation): 동시에 실행되는 트랜잭션이 서로 간섭하지 않음
지속성(Durability): 커밋된 결과는 장애가 나도 유지
여기까지가 아주 기본
트랜잭션은 격리 수준, 전파, 동시성과 락 등 엄청나게 많은 개념을 포함합니다. 세미나에서 모두 다루면 이틀은 걸릴 것 같아서 심화 개념은 미미나에서 알아봅니다.
비유
택배 “교환”은 반품 회수와 새 상품 발송이 한 묶음입니다. 회수만 되고 발송이 안 되면 안 되므로, 둘 다 되거나 둘 다 취소되어야 합니다.
예시
UPDATE account SET balance = balance - 10000 WHERE id = 1; -- A 계좌 출금-- ⚡ 여기서 서버가 죽는다면?
UPDATE account SET balance = balance + 10000 WHERE id = 2; -- B 계좌 입금
START TRANSACTION;
UPDATE account SET balance = balance - 10000 WHERE id = 1;
UPDATE account SET balance = balance + 10000 WHERE id = 2;
COMMIT; -- 모두 성공하면 확정-- ROLLBACK; -- 하나라도 실패하면 전부 취소
기술 도메인
Spring에서는 SQL로 START TRANSACTION을 쓰는 대신 Service 메서드에 @Transactional을 붙여 경계를 정합니다(5-4, 6장). 2차 세미나의 AOP 프록시가 메서드 앞뒤에서 시작·커밋·롤백을 대신 호출합니다. MySQL InnoDB의 기본 격리 수준은 REPEATABLE_READ입니다(실습 로그 참고).
테이블
ACID
성질
의미
이체 예시
원자성 (Atomicity)
전부 성공하거나 전부 실패
출금만 되고 입금이 안 되는 일은 없다
일관성 (Consistency)
트랜잭션 전후로 데이터가 규칙(제약 조건)을 만족
잔액이 음수가 되지 않는다, 총액이 보존된다
격리성 (Isolation)
동시에 실행되는 트랜잭션이 서로 간섭하지 않음
이체 도중의 중간 상태를 다른 사람이 보지 못한다
지속성 (Durability)
커밋된 결과는 장애가 나도 유지
커밋 직후 서버가 꺼져도 이체 결과는 남는다
보완격리성은 “전혀 간섭하지 않음”이 아니라 격리 수준에 따라 정도가 달라집니다. 낮은 수준에서는 Dirty Read · Non-Repeatable Read · Phantom Read 같은 현상이 허용될 수 있고, 수준을 높일수록 동시 처리량이 줄어드는 트레이드오프가 있습니다.
1-14인덱스와 동작 원리
핵심인덱스는 특정 열의 값을 정렬된 자료구조로 따로 저장해 검색 속도를 높이는 장치입니다. 주로 B-Tree / B+Tree(B = Balanced)로 구성됩니다.
이론
Full Table Scan
게시글이 1,000만 개일 때 WHERE member_id = 1을 실행하면, 인덱스가 없는 DB는 1,000만 행을 처음부터 끝까지 읽어야 합니다. 이를 Full Table Scan이라 합니다.
인덱스의 구성 요소
인덱스 키(Key): 인덱스 대상 컬럼의 값
레코드를 찾기 위한 정보: 해당 레코드 또는 다른 인덱스에서 레코드를 찾아갈 수 있는 키
B-Tree / B+Tree의 구조
여기서 B는 Binary가 아니라 Balanced입니다. DBMS마다 다른 구조로 인덱스를 제공하며, Hash 등으로 제공하는 DB도 있지만 여기서는 자료구조보다 구성과 동작에 집중합니다.
내부 노드가 키 범위를 나누고, 리프 노드에서 값을 찾는다
부모 노드에서 조회 대상 키의 범위를 특정해 자식 노드로 내려가며 탐색합니다. 핵심은 페이지 단위로 읽는 디스크 탐색 횟수를 줄여서 성능을 높이는 것입니다.
비유
책 뒤편의 찾아보기(색인)와 같습니다. “트랜잭션”이라는 단어를 찾으려고 책 전체를 넘기지 않고, 색인에서 페이지 번호를 찾아 바로 이동하죠. 색인 자체도 ㄱ·ㄴ·ㄷ 구획(내부 노드)으로 나뉘어 있어 빠르게 내려갑니다.
예시
CREATE INDEX idx_post_member_id ON post (member_id);
-- 인덱스를 타는지 실행 계획으로 확인
EXPLAIN SELECT * FROM post WHERE member_id = 1;
-- type: ref, key: idx_post_member_id → 인덱스 사용-- type: ALL → Full Table Scan
기술 도메인
MySQL InnoDB에서 PK는 클러스터드 인덱스로 리프에 행 데이터 전체가 저장되고, 보조 인덱스의 리프에는 PK 값이 저장됩니다. 그래서 보조 인덱스로 찾은 뒤 PK 인덱스를 한 번 더 탐색합니다 — 원문의 “다른 인덱스에서 레코드를 찾아갈 수 있는 키”가 이것입니다. JPA에서는 @Table(indexes = @Index(columnList = "member_id"))로 선언할 수 있습니다.
테이블
인덱스 자료구조와 DBMS (원문)
인덱스 자료구조
DBMS
B-Tree
PostgreSQL, Oracle
B+Tree
MySQL, MS SQL
보완PostgreSQL과 Oracle도 문서상 “B-Tree 인덱스”라고 부르지만, 실제 구현은 데이터를 리프에 두고 리프끼리 연결한 B+Tree 계열입니다. 즉 위 표는 “이름”의 차이에 가깝고, 주요 RDBMS의 기본 인덱스는 모두 B+Tree 변형이라고 이해하면 됩니다. B+Tree는 리프가 연결 리스트로 이어져 있어 범위 검색·정렬에 특히 유리합니다.
1-15인덱스의 트레이드오프
핵심인덱스는 조회를 빠르게 하는 대신 쓰기가 느려지고 저장 공간을 씁니다. 그래서 자주 검색되고 카디널리티가 높은 열에 거는 것이 원칙입니다.
이론
지표는 서로 충돌한다
1차 세미나의 “지표는 서로 충돌한다”의 대표 예시입니다. 조회(SELECT)와 정렬·범위 검색은 빨라지지만, INSERT·UPDATE·DELETE 시 인덱스도 함께 갱신해야 해서 쓰기가 느려지고 추가 저장 공간이 필요합니다.
어디에 걸까
모든 열에 인덱스를 거는 게 아니라, 자주 검색되고 값의 종류가 다양한(카디널리티가 높은) 열에 겁니다.
정렬 유지 비용과 append-only
인덱스 구조의 핵심은 탐색 키가 정렬된 형태로 유지된다는 점입니다. 데이터 생성·수정 과정에서 인덱스의 재배치로 쓰기 성능 저하가 생길 수 있으므로, PK나 조회 조건 컬럼은 생성 시점에 순차성을 부여해 append-only(항상 끝에 추가)를 보장하기도 합니다.
비유
책에 색인을 많이 만들수록 찾기는 쉬워지지만, 개정판을 낼 때마다 모든 색인의 페이지 번호를 다시 맞춰야 합니다. 성별처럼 값이 두세 개뿐인 단어는 색인을 만들어도 결국 절반의 페이지를 넘겨야 합니다.
예시
✓ 인덱스 효과가 큰 열
member_id, email, created_at — 값이 다양하고 WHERE·ORDER BY에 자주 쓰임
✗ 효과가 작은 열
is_deleted, gender — 값의 종류가 적어 대부분의 행을 읽게 됨
-- 순차 PK: 항상 B+Tree의 오른쪽 끝에 추가 → 페이지 분할 최소화
id BIGINT AUTO_INCREMENT PRIMARY KEY
-- 랜덤 UUID(v4) PK: 중간 삽입이 잦아 페이지 분할 증가
기술 도메인
UUID v4는 무작위라 InnoDB 클러스터드 인덱스에 불리합니다. 그래서 시간 순으로 증가하는 TSID, UUID v7 같은 ID가 쓰입니다 — 4-2의 기본키 생성 전략과 연결됩니다.
테이블
인덱스의 장단점
장점
단점
조회(SELECT) 속도 향상
INSERT, UPDATE, DELETE 시 인덱스도 함께 갱신해야 해서 쓰기가 느려짐
정렬, 범위 검색 향상
추가 저장 공간 필요
02자바에서 DB에 접근하기
DB가 무엇인지 알았으니, 이제 우리의 Spring 서버가 DB와 대화하는 방법을 알아봅니다.
2-1JDBC
핵심JDBC(Java Database Connectivity)는 자바에서 DB에 접근하기 위한 표준 인터페이스입니다. 애플리케이션은 인터페이스에만 의존하고, DBMS별 드라이버는 갈아끼울 수 있습니다.
이론
문제: DBMS마다 통신 방식이 다르다
DB는 MySQL, PostgreSQL, Oracle 등 종류가 많고 각자 통신 방식도 다릅니다. 결국 DBMS를 바꿀 때마다 연결 설정, 통신 방식 등을 전부 바꿔야 하는 상황이 생깁니다.
해결: 표준 인터페이스
JDBC는 자바에서 DB에 접근하기 위한 표준 인터페이스입니다. 애플리케이션은 JDBC API를 호출하고, JDBC Driver Manager가 각 DBMS용 드라이버로 연결합니다.
Application → JDBC API → Driver Manager → DBMS별 드라이버
여기에도 DIP
1차 세미나의 DIP가 여기에도 있습니다. 애플리케이션은 JDBC의 인터페이스에만 의존하고, 실제 구현체(드라이버)는 갈아끼울 수 있습니다.
비유
JDBC는 멀티 어댑터의 표준 콘센트입니다. 나라(DBMS)마다 플러그 모양이 달라도, 노트북(애플리케이션)은 표준 콘센트에만 꽂고 나라별 변환 플러그(드라이버)만 바꿉니다.
예시
// 인터페이스(java.sql)만 사용 — MySQL이든 PostgreSQL이든 같은 코드
Connection conn = DriverManager.getConnection(URL, USERNAME, PASSWORD);
PreparedStatement pstmt = conn.prepareStatement("SELECT ...");
ResultSet rs = pstmt.executeQuery();
// 드라이버는 의존성만 교체 (build.gradle)
runtimeOnly 'com.mysql:mysql-connector-j' // MySQL// runtimeOnly 'org.postgresql:postgresql' // PostgreSQL
핵심순수 JDBC는 커넥션 획득 · SQL 준비 · 바인딩 · 실행 · 변환 · 예외 처리 · 자원 반납을 매번 직접 해야 합니다. JDBC Template은 이 반복을 대신 처리해 쿼리와 결과 매핑에만 집중하게 해 줍니다.
이론
순수 JDBC의 7단계
커넥션 획득
SQL 준비
파라미터 바인딩
실행
결과를 객체로 변환
예외 처리
자원 반납
JDBC 덕분에 특정 DBMS에 종속되지 않고 자원을 불러오고 쿼리를 실행해 결과를 받을 수 있게 되었지만, 비즈니스 로직 이외의 코드가 너무 많아졌습니다.
JDBC Template
개발자가 직접 하던 자원 획득, 파라미터 바인딩, 예외 처리, 연결 자원 반납 같은 반복적이고 비즈니스 로직과 떨어진 과정을 자동으로 수행합니다. 개발자는 비즈니스 로직과 직접 연관된 쿼리문 작성과 결과 반환에만 집중할 수 있습니다.
비유
순수 JDBC는 매번 주방 문 열기 → 불 켜기 → 요리 → 설거지 → 문 잠그기를 혼자 하는 것, JDBC Template은 레시피(SQL)와 플레이팅(매핑)만 주면 나머지는 주방 스태프가 해 주는 것입니다.
예시
순수 JDBC
public Post findById(Long id) {
    String sql = "SELECT id, title, content FROM post WHERE id = ?";
    Connection conn = null;
    PreparedStatement pstmt = null;
    ResultSet rs = null;

    try {
        // 1. 커넥션 획득
        conn = DriverManager.getConnection(URL, USERNAME, PASSWORD);

        // 2. SQL 준비
        pstmt = conn.prepareStatement(sql);

        // 3. 파라미터 바인딩
        pstmt.setLong(1, id);

        // 4. 실행
        rs = pstmt.executeQuery();

        // 5. 결과를 객체로 변환
        if (rs.next()) {
            return new Post(
                rs.getLong("id"),
                rs.getString("title"),
                rs.getString("content")
            );
        }
        return null;
    } catch (SQLException e) {    // 6. 예외 처리
        throw new RuntimeException(e);
    } finally {
        // 7. 자원 반납
        close(rs);
        close(pstmt);
        close(conn);
    }
}
JDBC Template
public Post findById(Long id) {
    String sql = "SELECT id, title, content FROM post WHERE id = ?";

    return jdbcTemplate.queryForObject(sql,
        (rs, rowNum) -> new Post(
                rs.getLong("id"),
                rs.getString("title"),
                rs.getString("content")
            ),
        id);
}
기술 도메인
JDBC Template은 SQLException(체크 예외)을 Spring의 DataAccessException 계층(언체크 예외)으로 변환해 줍니다. 덕분에 Service가 특정 DB 예외에 묶이지 않습니다. 그래도 남는 문제 — DBMS마다 다를 수 있는 SQL에 종속되고, 데이터 ↔ 자바 객체 매핑(RowMapper)을 여전히 직접 해야 한다는 점 — 은 ORM(3장)이 다룹니다.
보완두 코드는 결과가 없을 때 동작이 다릅니다. 순수 JDBC 예시는 null을 반환하지만, queryForObject는 EmptyResultDataAccessException을 던집니다. “없을 수도 있는 조회”라면 query(...)로 List를 받아 Optional로 감싸는 방식이 안전합니다. 또 try-with-resources를 쓰면 순수 JDBC의 finally 블록도 줄일 수 있습니다.
2-3커넥션은 비싸다 · 커넥션 풀
핵심DB 커넥션은 TCP 연결 · 인증 · 세션 생성이 필요한 비싼 자원입니다. 커넥션 풀은 시작 시점에 커넥션을 미리 만들어 두고 빌려 쓰고 반납합니다.
이론
커넥션이란
지난 세미나들에서 언급했듯 DB도 결국 분리된 서버이고 WAS와 통신합니다. WAS는 DB가 내부적으로 어떻게 동작하는지 모르고 SQL이라는 인터페이스로 상호작용합니다. 클라이언트-서버 간에 통신이 필요하듯 서버-DB 간에도 통신이 필요하고, 그 통로가 커넥션입니다.
DriverManager.getConnection()마다 일어나는 일
TCP 3-way handshake로 DB 서버와 연결
DB 사용자 인증 (ID, 비밀번호)
DB 서버에 세션 생성
쿼리 실행
연결 종료
WAS와 DB도 TCP 기반이라 HTTP처럼 연결 작업이 필요합니다. 그런데 DB 통신은 HTTP 요청보다 더 많이, 자주 일어나기 때문에 쿼리 실행보다 연결을 맺고 끊는 비용이 더 클 수도 있습니다.
커넥션 풀(Connection Pool)
1차 세미나의 스레드 풀과 같은 아이디어입니다. 애플리케이션 시작 시점에 DB 커넥션을 미리 여러 개 만들어 두고, 필요할 때 빌려 쓰고 반납합니다.
요청 큐 → 스레드 풀 → 커넥션 풀 → DB (미리 맺어 둔 TCP 연결은 반납해도 끊지 않음)
HikariCP와 DataSource
Spring Boot는 기본 커넥션 풀로 HikariCP를 사용하며, 설정 파일의 DataSource를 보고 커넥션을 얻습니다. dataSource.getConnection()은 새로 만드는 것이 아니라 풀에서 빌려오는 것입니다.
비유
손님이 올 때마다 택시를 새로 불렀다 돌려보내는 대신, 회사 앞에 셔틀 몇 대를 대기시켜 두고 순서대로 태워 보내는 것입니다. 셔틀은 손님을 내려도 차고로 돌아가지 않고 다음 손님을 기다립니다.
예시
Connection conn = dataSource.getConnection();   // 새로 만드는 게 아니라 풀에서 빌려온다
try (conn) {
    // 쿼리 실행
}   // close() → 실제 연결 종료가 아니라 풀에 반납
기술 도메인
풀이 돌려주는 Connection은 실제 커넥션을 감싼 프록시라서 close()를 호출하면 끊지 않고 반납합니다. 반납을 잊으면(커넥션 누수) 풀이 고갈되어 다른 요청이 모두 대기하게 됩니다. JDBC Template·JPA를 쓰면 Spring이 트랜잭션 경계에 맞춰 획득·반납을 관리합니다.
2-4스레드 풀과 커넥션 풀
핵심Tomcat 스레드(기본 최대 200)는 HikariCP 커넥션(기본 10)보다 훨씬 많습니다. 커넥션 풀을 무작정 늘리기보다 커넥션을 짧게 쓰고 빨리 반납(= 트랜잭션을 짧게)하는 것이 중요합니다.
이론
1·2차 세미나 내용 합치기
Tomcat 스레드 풀과 HikariCP 커넥션 풀의 크기는 모두 설정으로 조절할 수 있습니다(테이블·예시 참고).
200개 요청이 동시에 DB를 쓴다면?
10개 스레드는 커넥션을 얻어 쿼리를 실행하고, 나머지 190개 스레드는 커넥션이 반납되기를 기다립니다. 기본적으로 30초 대기 후 타임아웃이 납니다.
💭 커넥션 풀을 200개로 늘리면 될까?
DB 서버도 결국 컴퓨터에서 돌아가는 서버라 CPU 코어와 디스크가 한정되어 있습니다. 커넥션이 너무 많으면 DB 내부에서 컨텍스트 스위칭과 자원 경쟁이 늘어나 오히려 느려집니다(1차 세미나의 스레드 이야기와 동일). 그래서 커넥션을 짧게 쓰고 빨리 반납하는 것, 즉 트랜잭션을 짧게 유지하는 것이 중요합니다.
여기까지의 정리와 남은 문제
JDBC와 JDBC Template으로 DBMS 종속성을 낮추고, 커넥션 풀로 연결 자원 생성 오버헤드를 줄였습니다. 하지만 여전히 DBMS마다 다를 수 있는 SQL에 종속되고, 개발자가 비즈니스 로직과 거리가 먼 데이터-자바 객체 매핑을 직접 해야 하는 문제가 남아 있습니다.
비유
식당 직원(스레드)이 200명이어도 화구(커넥션)가 10개면 동시에 요리할 수 있는 건 10명뿐입니다. 화구를 200개로 늘려도 가스 공급(DB CPU·디스크)이 한정되어 불이 약해집니다. 각자 화구를 빨리 비워 주는 게 답입니다.
예시
풀 크기 설정
server:
  tomcat:
    threads:
      max: 400        # 기본 200, 요청이 많아지면 톰캣이 스레드풀 크기를 400까지 조절
      min-spare: 10   # 기본 10, 요청이 없어도 최소한 10개의 스레드를 유지
spring:
  datasource:
    hikari:
      maximum-pool-size: 30   # 기본 10, 요청이 많아지면 hikariCP가 커넥션풀 크기를 30까지 조절
      minimum-idle: 10        # 기본 10, 요청이 없어도 최소한 10개의 커넥션을 유지
200개 요청 vs 커넥션 10개
200개 스레드 ──▶ 커넥션 10개
                 ├─ 10개 스레드: 커넥션을 얻어 쿼리 실행
                 └─ 190개 스레드: 커넥션이 반납되기를 대기 (기본 30초 대기 후 타임아웃)
기술 도메인
트랜잭션 안에서 외부 API 호출·파일 업로드처럼 오래 걸리는 작업을 하면 그동안 커넥션을 붙잡고 있게 됩니다. 이런 작업은 트랜잭션 밖으로 빼는 것이 좋습니다. 대기 시간은 spring.datasource.hikari.connection-timeout(기본 30000ms)으로 조절합니다.
테이블
기본 크기 (Spring Boot)
풀
기본 크기 (Spring Boot)
Tomcat 스레드 풀
최대 200개, 기본 10 (threads.max / min-spare)
HikariCP 커넥션 풀
최대 10개, 기본 10 (maximum-pool-size / minimum-idle)
보완원문의 설정 예시는 tomcat이 spring: 아래에 있고 들여쓰기도 어긋나 있었습니다. Tomcat 스레드 설정의 실제 키는 server.tomcat.threads.max, server.tomcat.threads.min-spare이므로 위처럼 server: 아래에 둡니다. 또 HikariCP의 minimum-idle 기본값은 maximum-pool-size와 같고, HikariCP는 고정 크기 풀(두 값을 같게)을 권장합니다.
03ORM
자바와 DB를 연결했지만 두 개념은 여전히 달라서, 결국 개발자가 DB에 맞춰 개발하고 객체-테이블 변환과 SQL 작성까지 담당하게 됩니다. 이 차이를 메우는 기술이 ORM입니다.
3-1패러다임 불일치 · 상속
핵심객체지향은 추상화·상속·다형성으로 데이터와 행위를 함께 다루고, RDB는 데이터를 정규화해 테이블에 저장합니다. 목적이 달라 생기는 표현 차이를 객체-관계 패러다임 불일치라 합니다. 첫 번째 예가 상속입니다.
이론
패러다임 불일치(Object-Relational Impedance Mismatch)
서버는 데이터를 다루는 영역이므로 개발자가 DB에 맞춰 개발하게 되고, 객체-테이블 변환과 SQL 작성 같은 부가 작업도 떠안습니다. 객체지향과 RDB는 지향하는 목적이 달라서 표현 방법에 차이가 생깁니다.
❶ 상속 — 테이블에는 상속이 없다
비슷하게 표현하려면 부모 item과 자식 album·book 테이블로 나누고, 해당 아이템이 어떤 타입의 자식인지 나타내는 dtype 컬럼을 추가해야 합니다.
저장과 조회가 복잡해진다
Album을 저장하려면 item과 album에 INSERT를 두 번, 조회하려면 JOIN이 필요합니다.
비유
객체는 가계도(부모의 특징을 물려받음)로 생각하고, 테이블은 칸이 고정된 장부로 생각합니다. 가계도를 장부에 옮기려면 “공통 장부 + 종류별 장부 + 종류 표시 칸”으로 쪼개야 합니다.
예시
abstract class Item {
    Long id;
    String name;
    int price;
}

class Album extends Item {
    String artist;
}

class Book extends Item {
    String author;
    String isbn;
}
item  (id, name, price, dtype)
album (item_id, artist)
book  (item_id, author, isbn)
-- Album 하나 저장
INSERT INTO item (id, name, price, dtype) VALUES (1, '앨범', 15000, 'ALBUM');
INSERT INTO album (item_id, artist) VALUES (1, '아이유');
-- Album 조회
SELECT * FROM item i JOIN album a ON i.id = a.item_id WHERE i.id = 1;
기술 도메인
JPA는 @Inheritance(strategy = JOINED | SINGLE_TABLE | TABLE_PER_CLASS)와 @DiscriminatorColumn(= dtype)으로 이 매핑을 자동화합니다. 개발자는 em.persist(album) 한 번만 호출하면 INSERT 두 번은 JPA가 실행합니다.
보완원문 설명 중 “album과 book을 item과 일대다 관계로 설정”은 정확히는 일대일(1:0..1) 관계입니다. 아이템 하나는 앨범 행을 최대 하나만 가지며, album.item_id가 PK이자 item.id를 참조하는 FK가 됩니다.
3-2연관관계 · 방향성
핵심객체는 참조(단방향), 테이블은 외래키(JOIN으로 양방향)로 관계를 표현합니다. SQL 중심으로 개발하면 객체가 참조 대신 FK 값을 들고 있는 테이블에 맞춘 객체가 됩니다.
이론
표현 방식의 차이
객체는 다른 객체 자체를 참조로 가지고, 테이블은 외래키 값을 가집니다.
방향성의 차이
객체는 단방향입니다 — post → member는 가능하지만, member → post는 필드가 없으면 불가능합니다. 테이블은 JOIN 하나로 어느 쪽에서든 조회 가능한 양방향입니다.
테이블에 맞춘 객체
SQL 중심으로 개발하면 Post가 Member 참조 대신 Long memberId를 들고 있게 되어, post.getMember().getName()처럼 객체답게 쓸 수 없습니다.
다대다
다대다 연관관계 같은 경우 객체는 List 같은 컬렉션으로 직접 구현할 수 있지만, 관계형 DB에서는 직접 표현이 불가능하다는 차이도 있습니다(1-8).
비유
객체 참조는 친구의 연락처를 내 폰에 저장하는 것(나만 상대를 앎), 외래키는 공용 전화번호부(누구든 양쪽으로 찾아볼 수 있음)입니다.
예시
객체 — 참조를 가진다
class Post {
    Member member;     // 객체 자체를 참조
}
post.getMember().getName();
테이블 — 외래키 값을 가진다
post (id, title, member_id)
SQL 중심 → 테이블에 맞춘 객체
class Post {
    Long memberId;    // 참조 대신 외래키 값을 그대로 들고 있음
}
기술 도메인
JPA는 @ManyToOne + @JoinColumn으로 객체 참조 ↔ FK 컬럼을 연결합니다(4-6). 객체에서 양방향이 필요하면 반대쪽에 @OneToMany(mappedBy)를 추가하지만, 이때 어느 쪽이 FK를 관리할지(연관관계의 주인)를 정해야 합니다(4-7).
테이블
객체 vs 테이블의 관계 표현
객체
테이블
관계 표현
참조 (post.getMember())
외래키 (member_id)
방향
단방향 — post → member는 가능, member → post는 필드가 없으면 불가능
양방향 — JOIN 하나로 어느 쪽에서든 조회 가능
3-3객체 그래프 탐색 · 동일성 비교
핵심객체는 참조를 따라 자유롭게 이동해야 하지만, SQL 방식에서는 처음 실행한 SQL이 탐색 범위를 정합니다. 또 같은 행을 두 번 조회하면 서로 다른 객체가 됩니다.
이론
❸ 객체 그래프 탐색
객체는 게시글 → 작성자 → 소속 팀 → 팀 이름처럼 참조를 따라 자유롭게 이동할 수 있어야 합니다. 그런데 SQL 조회 결과에서는 처음 실행한 SQL이 어디까지 조회했는지(JOIN 범위)에 따라 탐색 범위가 결정됩니다.
계층 분리가 무너진다
getTeam()이 null인지 알려면 DAO 안의 SQL을 열어봐야 합니다. 계층을 나눴지만 실제로는 Service가 Repository의 SQL에 강하게 의존하게 됩니다.
❹ 동일성 비교
같은 DB 행을 조회했지만 조회할 때마다 new로 새 객체를 만들었으므로 자바 입장에서는 서로 다른 객체입니다. 컬렉션에 넣어 둔 객체라면 == 비교가 당연히 true일 텐데 말이죠.
정리
객체를 객체답게 모델링할수록 매핑 작업만 늘어나고, 결국 객체를 테이블에 맞추게 됩니다. 1차 세미나에서 배운 객체지향 설계가 DB 앞에서 무너지는 것입니다.
비유
지도 앱에서 미리 다운로드한 지역(처음 SQL의 JOIN 범위) 밖으로 이동하면 지도가 비어 보입니다. 그리고 같은 사람의 사진을 두 번 인화하면 같은 사람이지만 다른 종이입니다.
예시
post.getMember().getTeam().getName();   // 게시글 → 작성자 → 소속 팀 → 팀 이름

Post post = postDao.findById(1L);   // SELECT * FROM post p JOIN member m ... (team은 JOIN 안 함)
post.getMember().getTeam();         // null!
Member member1 = memberDao.findById(1L);
Member member2 = memberDao.findById(1L);

member1 == member2;   // false — 같은 행인데 조회할 때마다 new로 새 객체를 만들었으니까
기술 도메인
JPA는 지연 로딩(5-5)으로 실제 접근 시점에 필요한 SQL을 실행해 그래프 탐색을 지원하고, 1차 캐시(5-2)로 같은 영속성 컨텍스트 안에서 같은 행은 같은 인스턴스를 돌려줘 동일성을 보장합니다.
3-4ORM이란? 장점과 한계
핵심ORM(Object-Relational Mapping)은 객체와 관계형 DB 테이블을 연결(매핑)해 주는 기술입니다. 가장 큰 장점은 패러다임 불일치 해결, 한계는 내부를 모르면 의도치 않은 SQL이 나간다는 점입니다.
이론
정의
개발자가 DB 테이블을 직접 다루는 대신 Java 객체를 중심으로 데이터를 조회·저장할 수 있게 도와주는 기술입니다.
개발자는 객체를 다루고, SQL 작성과 결과 매핑은 ORM이 대신한다
장점
생산성: 반복적인 CRUD SQL을 작성하지 않음
유지보수: 필드를 추가해도 매핑 정보만 수정하면 SQL은 자동 반영
패러다임 불일치 해결: 상속, 연관관계, 객체 그래프 탐색, 동일성 비교 지원 — ORM의 등장 배경이자 가장 큰 장점
DB 독립성: DB 방언(Dialect)을 바꾸면 MySQL → PostgreSQL 전환이 쉬움
성능 최적화 기능: 1차 캐시, 쓰기 지연, 지연 로딩 등 (5장)
한계
학습 비용: 내부 동작을 모르면 의도하지 않은 SQL이 대량으로 실행될 수 있음 (N+1 문제)
복잡한 쿼리: 통계, 복잡한 JOIN 등은 결국 SQL(또는 QueryDSL 같은 도구)이 필요
추상화의 누수: ORM이 SQL을 숨기지만, 성능 문제를 풀려면 결국 SQL과 DB를 알아야 함
결론
ORM은 JDBC처럼 특정 DBMS에 종속되지 않으면서 편리한 기능을 제공하지만, 그만큼 제공되지 않는 기능도 많습니다. 좋은 성능과 안정성을 위해서는 앞에서 살펴본 DB 개념이 ORM과 함께 적절히 활용되어야 합니다.
비유
ORM은 통역사입니다. 나는 한국어(객체)로 말하고 통역사가 영어(SQL)로 전달합니다. 편하지만, 통역이 이상하게 될 때(N+1) 원인을 찾으려면 결국 영어도 조금은 알아야 합니다.
예시
postRepository.save(post);        // → INSERT INTO post ...
postRepository.findById(1L);      // → SELECT ... FROM post WHERE id = ?
post.getMember().getName();       // → (지연 로딩) SELECT ... FROM member WHERE id = ?
기술 도메인
개발 중에는 spring.jpa.show-sql, format_sql로 실제 SQL을 항상 확인합니다(6장 설정). “추상화의 누수”를 가장 먼저 발견하는 방법이 SQL 로그입니다.
테이블
ORM의 장점
장점
설명
생산성
반복적인 CRUD SQL을 작성하지 않음
유지보수
필드를 추가해도 매핑 정보만 수정하면 SQL은 자동 반영
패러다임 불일치 해결
상속, 연관관계, 객체 그래프 탐색, 동일성 비교를 지원
DB 독립성
DB 방언(Dialect)을 바꾸면 MySQL → PostgreSQL 전환이 쉬움
성능 최적화 기능
1차 캐시, 쓰기 지연, 지연 로딩 등 (5장)
ORM의 한계
한계
설명
학습 비용
내부 동작을 모르면 의도하지 않은 SQL이 대량으로 실행될 수 있음 (N+1 문제)
복잡한 쿼리
통계, 복잡한 JOIN 등은 결국 SQL(또는 QueryDSL 같은 도구)이 필요
추상화의 누수
ORM이 SQL을 숨기지만, 성능 문제를 풀려면 결국 SQL과 DB를 알아야 함
3-5JPA · Hibernate · Spring Data JPA
핵심JPA는 자바 ORM 표준 명세(인터페이스), Hibernate는 그 구현체, Spring Data JPA는 JPA를 편리하게 쓰게 해 주는 Spring 모듈입니다. 세 계층은 Spring Data JPA → JPA ← Hibernate → JDBC 방향으로 의존합니다.
이론
JPA
자바 ORM의 표준 명세입니다. 객체와 관계형 DB를 매핑하기 위한 인터페이스인 EntityManager를 제공하고, 엔티티 매핑·객체 조회·영속성 관리 등의 기능을 명세합니다. 명세(인터페이스)이므로 실제 SQL을 생성·실행하려면 구현체가 필요합니다. 또 JPQL을 제공해 객체를 대상으로 쿼리를 작성할 수 있게 합니다.
Hibernate
JPA를 구현한 ORM 프레임워크입니다. JPA 인터페이스를 구현해 엔티티와 테이블을 매핑하고, JPQL 기반 SQL 생성, 영속성 컨텍스트, 변경 감지 등을 실제로 구현합니다. JDBC를 이용해 DB와 통신하며, JPA 표준이 아닌 자체 기능도 제공합니다.
Spring Data JPA
JPA를 편리하게 쓰도록 지원하는 Spring Data 프레임워크의 하위 모듈입니다. 대표 기능은 JpaRepository로, 반복적인 데이터 접근 코드를 줄여 줍니다. 인터페이스만으로 기본 CRUD를 제공하고 JPQL로 작성한 기능을 실행할 수 있게 해 줍니다.
의존 방향
Application → Spring Data JPA(Repository) / JPA(EntityManager) → Hibernate → JDBC → DB
우리가 쓰는 Spring Data JPA는 JPA라는 ORM 인터페이스에 의존하고, 구현체인 Hibernate가 그 인터페이스를 구현합니다(여기서 DIP가 적용되었네요). Hibernate는 JDBC에 의존해 실제 DB와 통신하며, 자바로 데이터에 접근할 수 있게 됩니다.
비유
JPA는 운전면허 규정(표준), Hibernate는 그 규정을 만족하는 실제 자동차, Spring Data JPA는 자율주행 보조 기능, JDBC는 도로입니다. 규정만 지키면 차 브랜드(구현체)를 바꿔도 운전법은 같습니다.
예시
Raw JPA — EntityManager 직접 사용
Post post = em.find(Post.class, 1L);
em.persist(newPost);
em.createQuery("select p from Post p", Post.class)
  .getResultList();
spring-boot-starter-data-jpa 하나를 추가하면 Spring Data JPA + JPA API(Jakarta Persistence) + Hibernate + HikariCP가 함께 들어옵니다(6장). Spring Boot 3 이후 패키지는 javax.persistence가 아니라 jakarta.persistence입니다.
테이블
세 계층 비교
구분
정체
대표 요소
의존
JPA
자바 ORM 표준 명세(인터페이스)
EntityManager, JPQL, 매핑 어노테이션
구현체 필요
Hibernate
JPA 구현 ORM 프레임워크
SQL 생성, 영속성 컨텍스트, 변경 감지 + 자체 기능
JPA 구현, JDBC 사용
Spring Data JPA
Spring Data의 하위 모듈
JpaRepository, 쿼리 메서드
JPA에 의존
04Spring Data JPA 기본
데이터베이스, JDBC, ORM, JPA가 무엇인지 살펴봤으니 이제 실제로 어떻게 사용하는지 알아봅니다.
4-1엔티티 기본 매핑
핵심엔티티(Entity)는 JPA가 관리하는, 테이블과 매핑되는 클래스입니다. @Entity · @Id · @Column 등으로 매핑하고, JPA가 쓸 기본 생성자를 protected로 둡니다.
이론
매핑 어노테이션
@Entity로 엔티티임을 선언하고, @Table로 테이블 이름, @Id로 PK, @GeneratedValue로 PK 생성 전략, @Column으로 열 이름·NULL 허용·길이·유니크, @Enumerated로 enum 매핑 방식을 지정합니다(테이블 참고). @Table을 생략하면 클래스 이름이 테이블 이름이 됩니다.
왜 기본 생성자가 필요할까?
JPA는 DB에서 조회한 데이터로 객체를 만들 때 리플렉션으로 기본 생성자를 호출한 뒤 필드를 채웁니다.
리플렉션은 프로그램 실행 중에 클래스·필드·메서드 정보를 조회하고, 이를 바탕으로 객체의 필드에 접근하거나 메서드를 호출하는 기능입니다.
JPA는 개발자가 어떤 엔티티를 만들지 모르므로 리플렉션으로 클래스를 분석하고 테이블과의 매핑 정보를 확인하면서 객체-테이블 매핑을 실행합니다.
protected로 막아 두면 JPA는 사용할 수 있고, 외부에서 의미 없는 빈 객체를 만드는 것은 방지할 수 있습니다.
비유
엔티티는 표준 양식의 빈 서류철입니다. JPA는 일단 빈 서류철(기본 생성자)을 꺼낸 뒤 DB에서 읽은 값을 칸마다 채워 넣습니다. 외부인이 빈 서류철을 함부로 만들지 못하게 서랍(protected)에 넣어 둡니다.
예시
@Entity                    // JPA가 관리하는 엔티티
@Table(name = "post")      // 매핑할 테이블 (생략 시 클래스 이름)
public class Post {
    // PK
    @Id
    // PK 생성을 DB에 위임 (AUTO_INCREMENT)
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(name = "title", nullable = false, length = 20)
    private String title;

    @Column(name = "content", nullable = false)
    private String content;

    @Enumerated(EnumType.STRING)          // enum을 문자열로 저장
    @Column(name = "category", nullable = false)
    private Category category;

    // JPA가 사용하는 기본생성자
    protected Post() {}

    public Post(String title, String content, Category category) {
        this.title = title;
        this.content = content;
        this.category = category;
    }
}
기술 도메인
nullable, length는 Hibernate가 DDL을 생성할 때 반영되는 정보이고, 런타임 입력 검증은 아닙니다. 요청 값 검증은 DTO의 Bean Validation(@NotBlank, @Size)이나 도메인 생성자에서 따로 합니다. Lombok을 쓴다면 @NoArgsConstructor(access = AccessLevel.PROTECTED)가 같은 역할입니다.
테이블
기본 매핑 어노테이션
어노테이션
역할
@Entity
이 클래스가 JPA 엔티티임을 선언
@Table
매핑할 테이블 이름 지정
@Id
기본키(PK) 필드
@GeneratedValue
기본키 생성 전략
@Column
열 매핑 (이름, NULL 허용, 길이, 유니크)
@Enumerated
enum 매핑 방식
4-2기본키 생성 전략
핵심간단하게는 순차적으로 키를 만드는 IDENTITY나 SEQUENCE를 씁니다. 하지만 예측 가능한 ID는 보안·정보 노출 문제가 있어 실제로는 UUID, TSID 또는 자체 발급 ID를 많이 씁니다.
이론
네 가지 전략
IDENTITY: DB의 AUTO_INCREMENT에 위임. INSERT를 실행해야 ID를 알 수 있음
SEQUENCE: DB 시퀀스 객체에서 값을 받아옴. ID를 INSERT 전에 생성
TABLE: 키 생성 전용 테이블 사용 (성능 이슈로 잘 안 씀)
AUTO: DB 방언에 따라 자동 선택 (기본값)
순차 ID의 문제 — 예측 가능하다
ID를 순차적으로 바꿔 가며 공개된 API를 대량으로 호출할 수 있습니다.
공개된 ID로 데이터의 대략적인 규모나 생성량을 추측할 수 있습니다.
HTTP 요청의 ID 값을 임의로 바꿔 권한 검증 없이 데이터에 접근할 수 있습니다.
실제로 대학교 학사정보 시스템에서 이 문제로 개인정보가 유출된 사례도 있습니다. 따라서 실제로는 UUID, TSID를 쓰거나 자체적으로 ID를 발급하는 경우가 많습니다.
비유
번호표가 1, 2, 3…이면 “오늘 손님이 몇 명 왔는지”와 “내 앞뒤 사람 번호”를 쉽게 짐작할 수 있습니다. 무작위 영수증 번호라면 짐작하기 어렵습니다 — 하지만 남의 영수증 번호를 알아도 물건을 못 찾게 하는 것(권한 검증)은 별개입니다.
예시
// IDENTITY — MySQL AUTO_INCREMENT
@Id @GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;

// UUID — JPA 3.1+
@Id @GeneratedValue(strategy = GenerationType.UUID)
private UUID id;

// 순차 ID가 노출된 API — ID만 바꾸면 남의 데이터?
GET /api/v1/members/1001/grades
GET /api/v1/members/1002/grades   ← 권한 검증이 없으면 조회됨
기술 도메인
내부 PK는 순차 BIGINT로 두고, 외부 API에는 별도의 공개용 ID(UUID 등)를 노출하는 방식도 많이 씁니다. 순차 PK는 인덱스에 유리하고(1-15), 공개 ID는 추측을 어렵게 합니다. TSID·UUID v7은 시간 순 정렬이 가능해 두 장점을 절충합니다.
테이블
기본키 생성 전략
전략
동작
대표 DB
IDENTITY
DB의 AUTO_INCREMENT에 위임. INSERT를 실행해야 ID를 알 수 있음
MySQL, PostgreSQL, Oracle
SEQUENCE
DB 시퀀스 객체에서 값을 받아옴 ID를 INSERT 전에 생성
PostgreSQL, Oracle
TABLE
키 생성 전용 테이블 사용 (성능 이슈로 잘 안 씀)
모든 DB
AUTO
DB 방언에 따라 자동 선택 (기본값)
-
보완① ID를 바꿔 남의 데이터에 접근하는 문제(IDOR)의 근본 해결책은 ID를 숨기는 것이 아니라 서버의 권한 검증입니다. UUID는 추측을 어렵게 하는 보조 수단일 뿐입니다. ② Hibernate 6에서 AUTO는 MySQL이라도 IDENTITY가 아니라 SEQUENCE 방식(시퀀스가 없으면 테이블로 흉내)을 고르는 경우가 많으므로, MySQL에서는 IDENTITY를 명시하는 것이 안전합니다.
4-3enum은 반드시 STRING으로
핵심@Enumerated의 기본값 ORDINAL은 순서 번호를 저장하므로, enum 앞에 값을 추가하는 순간 기존 데이터의 의미가 모두 바뀝니다. 반드시 EnumType.STRING을 씁니다.
ORDINAL로 저장하다가 누군가 enum Part { ANDROID, SERVER, IOS, WEB }처럼 앞에 값을 추가하면, 기존에 저장된 숫자가 가리키는 값이 전부 한 칸씩 밀립니다. 모든 정합성이 깨지게 됩니다.
비유
좌석을 “앞에서 3번째 사람”으로 기억하면, 맨 앞에 한 명이 끼어드는 순간 모두의 자리가 틀어집니다. “김솝트 자리”처럼 이름으로 기억해야 안전합니다.
예시
enum Part { SERVER, IOS, WEB }

@Enumerated(EnumType.ORDINAL)   // ⚠️ 기본값 — 순서(0, 1, 2)로 저장
@Enumerated(EnumType.STRING)    // ✅ 이름("SERVER")으로 저장
DB 값
변경 전 { SERVER, IOS, WEB }
변경 후 { ANDROID, SERVER, IOS, WEB }
0
SERVER
ANDROID
1
IOS
SERVER
2
WEB
IOS
기술 도메인
STRING도 enum 상수 이름을 바꾸면 기존 데이터와 매칭되지 않으므로, 이름 변경 시에는 데이터 마이그레이션(UPDATE ... SET part = 'NEW' WHERE part = 'OLD')이 필요합니다. 컬럼 길이(@Column(length = 20))도 가장 긴 상수명에 맞춰 둡니다.
보완원문은 “기존 데이터의 0은 SERVER가 아니라 WEB이 된다”고 적었지만, ANDROID를 맨 앞에 추가하면 0은 ANDROID로 해석됩니다. 같은 방식으로 IOS였던 1은 SERVER로, WEB이었던 2는 IOS로 바뀝니다(위 표). 결론(정합성 붕괴)은 같습니다.
4-4JpaRepository와 쿼리 메서드
핵심JpaRepository<엔티티, PK 타입>를 상속한 인터페이스만 선언하면 기본 CRUD가 제공되고, 메서드 이름으로 조건 쿼리도 만들 수 있습니다.
이론
Repository 인터페이스
Entity를 정의했다면 저장·조회 방법이 필요합니다. JPA에서는 EntityManager로 직접 데이터에 접근할 수 있지만, Spring Data JPA를 쓰면 Repository 인터페이스를 선언하는 것만으로 기본 기능을 쓸 수 있습니다. JpaRepository<Post, Long>의 첫 번째 타입은 Entity, 두 번째는 기본키 타입입니다.
구현체는 누가 만드나
Spring Data JPA가 Repository 인터페이스를 기반으로 구현체를 구성해 Spring Bean으로 제공합니다. 일반적으로 SimpleJpaRepository 등을 기반으로 동작합니다.
쿼리 메서드
메서드 이름을 일정한 규칙으로 작성하면 Spring Data JPA가 이를 분석해 쿼리를 생성합니다(이것도 리플렉션을 이용한 기능입니다). 조건이 복잡해지면 메서드 이름이 길어지고 표현력이 제한되므로, 상황에 따라 JPQL이나 QueryDSL을 고려합니다.
비유
“제목으로 찾아 줘”(findByTitle)라고 정해진 문법으로 주문서를 쓰면, 주방(Spring Data)이 알아서 레시피(SQL)를 만들어 줍니다. 주문이 너무 복잡해지면 직접 레시피(JPQL)를 적어 주는 편이 낫습니다.
예시
@Repository
public interface PostRepository extends JpaRepository<Post, Long> {

    Optional<Post> findByTitle(String title);       // where title = ?

    List<Post> findByCategory(Category category);    // where category = ?

    boolean existsByTitle(String title);             // 존재 여부
}

// 이름이 길어지는 예 → JPQL/QueryDSL 고려
List<Post> findByCategoryAndTitleContainingAndCreatedAtAfterOrderByCreatedAtDesc(...);
기술 도메인
쿼리 메서드의 이름은 애플리케이션 시작 시점에 파싱되므로, 존재하지 않는 필드명(findByTitel)을 쓰면 서버가 뜨지 않고 바로 에러가 납니다. 2차 세미나에서 본 것처럼 Bean 등록 시점에 문제를 일찍 발견하는 장점이 있습니다.
테이블
기본 제공 메서드
메서드
역할
save(entity)
Entity 저장 또는 병합
findById(id)
기본 키로 조회
findAll()
전체 조회
existsById(id)
존재 여부 확인
deleteById(id)
기본 키로 삭제
count()
전체 개수 조회
4-5@Query · JPQL · QueryDSL
핵심JPQL은 테이블이 아니라 Entity와 그 속성을 대상으로 작성하는 객체 지향 쿼리 언어이고, DB에 맞는 SQL로 변환되어 실행됩니다. 동적 조건이 많으면 QueryDSL을 씁니다.
이론
JPQL
DB 테이블이 아니라 Entity와 그 속성을 대상으로 작성합니다. 쿼리의 Post는 테이블명이 아니라 Entity 이름이며, p.title은 Entity의 필드를 의미합니다. JPQL은 DB에 맞는 SQL로 변환되어 실행됩니다.
QueryDSL
쿼리가 복잡하거나 동적으로 조건을 조합해야 할 때 사용합니다. Java 코드로 쿼리를 작성하고 컴파일 시점에 타입 검사의 이점을 얻을 수 있습니다. 예: 검색어가 입력된 경우에만 제목 조건을 추가하거나, 여러 필터 조건을 조합하는 조회.
비유
SQL은 창고 선반 번호로 물건을 찾는 말, JPQL은 상품 이름으로 찾는 말입니다. 통역(Hibernate)이 상품 이름을 선반 번호로 바꿔 줍니다.
예시
-- 일반적인 SQL
SELECT * FROM post WHERE title = ?;
// JPQL
@Query("select p from Post p where p.title = :title")
List<Post> findPostsByTitle(@Param("title") String title);
// QueryDSL — 검색어가 있을 때만 조건 추가
queryFactory.selectFrom(post)
    .where(keyword != null ? post.title.contains(keyword) : null,
           category != null ? post.category.eq(category) : null)
    .fetch();
기술 도메인
JPQL 문자열의 오타는 실행 전에는 알기 어렵지만, Spring Data JPA는 @Query도 시작 시점에 검증해 줍니다. QueryDSL은 Q타입(QPost)을 생성하는 별도 빌드 설정이 필요합니다.
보완원문의 설명 “여기서 Member는 테이블명이 아니라 Entity 이름이며 m.name은 Entity의 필드”는 예시 코드(Post p, p.title)와 맞지 않아, 위처럼 Post / p.title로 맞춰 적었습니다.
4-6객체 참조와 다대일 · 일대다
핵심연관관계 매핑은 패러다임 불일치가 실질적으로 해결되는 가장 중요한 부분입니다. FK를 가진 쪽에 @ManyToOne + @JoinColumn을 두면, 테이블의 외래키가 객체 참조로 바뀝니다.
이론
객체 참조와 외래 키
실제 서비스에서는 여러 Entity가 서로 연결됩니다(회원은 여러 게시글 작성, 게시글은 여러 댓글). RDB는 외래 키로, Java는 다른 Entity를 필드로 참조해 관계를 표현합니다.
@ManyToOne: 여러 게시글이 하나의 회원과 연결되는 관계
@JoinColumn: 연관관계를 표현하는 외래 키 컬럼 지정
FetchType.LAZY: 연관 Entity의 로딩을 지연
엔티티의 Member member 필드 ↔ 테이블의 member_id FK
엔티티 코드와 실제 테이블을 비교하면, Post에서 참조 방식이 외래키 → 객체 참조로만 바뀐 것을 확인할 수 있습니다.
다대일: @ManyToOne
일반적으로 다대일 관계에서는 외래키를 가지고 있는 쪽에 @ManyToOne을 선언합니다.
일대다: @OneToMany
mappedBy = "member"는 반대편 Entity인 Post의 member 필드가 연관관계를 관리한다는 의미입니다. Member.posts는 조회를 위한 반대편 참조이며, 이 필드 자체가 외래 키를 관리하지는 않습니다. 두 어노테이션을 1:N 관계에서 함께 쓰면 양방향 참조를 구현할 수 있습니다.
비유
테이블에서는 게시글이 작성자의 회원번호를 적어 두고, 엔티티에서는 게시글이 작성자의 명함 자체를 들고 있습니다. 명함이 있으니 번호로 다시 찾을 필요 없이 바로 이름을 읽을 수 있습니다.
예시
@Entity
public class Post {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String title;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "member_id")
    private Member member;
}
// 다대일: FK를 가진 쪽
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "member_id")
private Member member;

// 일대다: 반대편 (조회용)
@OneToMany(mappedBy = "member")
private List<Post> posts = new ArrayList<>();
기술 도메인
@ManyToOne의 기본 fetch는 EAGER이므로 fetch = FetchType.LAZY를 명시하는 것이 관례입니다(5-5). @OneToMany 컬렉션은 new ArrayList<>()로 바로 초기화해 NPE를 막습니다.
테이블
연관관계 어노테이션
어노테이션
의미
예시
@ManyToOne
여러 개가 하나와 연결
여러 게시글 → 하나의 회원
@OneToMany
하나가 여러 개와 연결
하나의 회원 → 여러 게시글
@OneToOne
하나가 하나와 연결
회원 하나 ↔ 프로필 하나
@ManyToMany
여러 개가 여러 개와 연결
여러 회원 ↔ 여러 게시글
4-7연관관계의 주인 · 단방향과 양방향
핵심양방향이면 어느 쪽이 FK를 관리할지 정해야 하고, 이를 연관관계의 주인이라 합니다. 보통 FK가 있는 N쪽(Post.member)이 주인입니다. 처음에는 다대일 단방향으로 시작하고, 필요할 때만 양방향을 추가합니다.
이론
연관관계의 주인
DB에서 일대다 관계의 FK가 다수 쪽 테이블에 있는 것처럼, 엔티티에도 같은 원칙이 적용됩니다. @ManyToOne과 @OneToMany로 양방향 참조를 만들어도 실제 DB에는 다수에 해당하는 post에만 FK 컬럼이 있습니다. 위 예시에서 Post.member가 주인이고 Member.posts는 반대편입니다.
반대편만 수정하면?
Member.posts에 게시글을 추가하는 것만으로는 DB의 외래 키가 갱신되지 않을 수 있습니다. 양쪽 객체의 참조를 일관되게 유지하려면 연관관계 편의 메서드를 사용합니다. 실제 구현에서는 기존 회원과의 관계 변경, 중복 추가 방지 등도 함께 고려해야 합니다.
단방향과 양방향
단방향: 한쪽 Entity에서만 다른 Entity를 참조
양방향: 양쪽 Entity에서 서로를 참조
자바 입장에서는 양쪽에서 모두 참조할 수 있으니 양방향이 더 편리하게 느껴지지만 항상 좋은 것은 아닙니다. 양쪽 참조를 일관되게 유지해야 하고, 순환 참조나 불필요한 로딩 문제가 생길 수 있습니다. 따라서 처음에는 필수적인 단방향으로만 설정하고, 반대 방향 탐색이 실제로 필요할 때 양방향을 고려합니다. 일반적으로 다대일 단방향부터 설계하는 방식이 단순합니다.
비유
학생증(Post)에 적힌 담임 이름이 공식 기록(주인)이고, 선생님 수첩(Member.posts)의 학생 목록은 메모입니다. 메모만 고쳐서는 학적부가 바뀌지 않습니다. 그래도 헷갈리지 않게 둘 다 함께 고치는 것이 편의 메서드입니다.
예시
@Entity
public class Post {
    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "member_id")
    private Member member;          // 연관관계의 주인 — FK 관리
}

@Entity
public class Member {
    @OneToMany(mappedBy = "member")
    private List<Post> posts = new ArrayList<>();   // 반대편 — 읽기 전용
}

// 연관관계 편의 메서드 (Post)
public void setMember(Member member) {
    this.member = member;
    member.getPosts().add(this);
}
// 기존 관계 변경 · 중복 추가 방지까지 고려한 버전
public void changeMember(Member member) {
    if (this.member != null) {
        this.member.getPosts().remove(this);
    }
    this.member = member;
    if (member != null && !member.getPosts().contains(this)) {
        member.getPosts().add(this);
    }
}
기술 도메인
양방향 엔티티를 그대로 JSON으로 응답하면 Post → Member → posts → Post …로 무한 순환이 생길 수 있습니다. 엔티티 대신 응답 DTO로 변환해 반환하면 순환 참조와 지연 로딩 문제를 함께 피할 수 있습니다.
4-8다대다 관계와 연결 Entity
핵심@ManyToMany는 간결하지만 관계 자체의 데이터(좋아요 시각 등)를 담기 어렵고 중간 테이블에 접근할 참조가 없어 거의 쓰지 않습니다. 중간 테이블을 연결 Entity(PostLike)로 만들어 두 개의 @ManyToOne으로 풀어냅니다.
이론
좋아요는 다대다
회원 한 명은 여러 게시글에 좋아요를 누를 수 있고, 게시글 하나는 여러 회원에게 좋아요를 받을 수 있으므로 Member와 Post는 다대다입니다.
MEMBER — POST_LIKE — POST
왜 연결 엔티티가 필요한가
DB에서는 다대다를 직접 표현하는 것이 거의 불가능했습니다(1-8). 자바에서는 컬렉션 양방향 참조로 가능은 하지만, 그러면 ORM이 해결하려는 패러다임 불일치를 해결하지 못하게 됩니다. 따라서 자바에서도 중간 테이블과 매핑되는 연결 엔티티를 사용합니다.
@ManyToMany와 @JoinTable
@JoinTable은 두 Entity 사이의 관계를 저장할 중간 테이블을 지정합니다. joinColumns는 현재 Entity(Member)를 참조하는 FK, inverseJoinColumns는 반대편 Entity(Post)를 참조하는 FK입니다. 하지만 좋아요를 누른 시각이나 상태처럼 관계 자체에 속하는 데이터는 표현하기 어렵고, 중간 테이블에 접근할 수 있는 참조가 자바에 없어 여전히 패러다임 불일치가 발생합니다.
연결 Entity로 분리
이제 Member와 Post는 각각 PostLike와 일대다 관계를 맺고, PostLike는 두 Entity를 다대일로 참조합니다. member_id와 post_id 조합에 복합 유니크 제약을 설정하면 동일 회원의 동일 게시글 중복 좋아요를 DB 차원에서도 막을 수 있습니다.
정리
@ManyToMany는 간결하지만 확장에 유연하지 못하고, 패러다임 불일치가 남아 있으며, 중간 테이블의 제약 조건 설정 같은 기능이 제한되어 거의 쓰이지 않습니다. 두 개의 @ManyToOne으로 연결 엔티티를 직접 구현하면 관계 자체에 별도 속성이나 비즈니스 로직이 필요할 때 유연하게 대응할 수 있습니다.
비유
@ManyToMany는 학생과 수업을 선으로만 연결한 그림, 연결 엔티티는 수강 신청서입니다. 신청서에는 신청 일시·상태도 적을 수 있고, 신청서 자체를 조회하거나 취소할 수도 있습니다.
예시
@ManyToMany로 표현하기
@Entity
public class Member {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToMany
    @JoinTable(
        name = "post_like",
        joinColumns = @JoinColumn(name = "member_id"),
        inverseJoinColumns = @JoinColumn(name = "post_id")
    )
    private List<Post> likedPosts = new ArrayList<>();
}
연결 Entity로 분리하기
@Entity
@Table(
    name = "post_like",
    uniqueConstraints = @UniqueConstraint(
        columnNames = {"member_id", "post_id"}
    )
)
public class PostLike {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "member_id", nullable = false)
    private Member member;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "post_id", nullable = false)
    private Post post;

    @Column(nullable = false)
    private LocalDateTime createdAt;
}
기술 도메인
좋아요 기능은 postLikeRepository.existsByMemberAndPost(...)로 중복을 먼저 확인하더라도, 동시 요청에서는 두 요청이 모두 “없음”을 볼 수 있습니다. 그래서 DB 유니크 제약이 최종 방어선이 되고, 위반 시 발생하는 DataIntegrityViolationException을 409 Conflict 등으로 변환합니다.
보완그림의 POST_LIKE는 (member_id, post_id) 복합키 버전이고, 코드의 PostLike는 대리키 id + 복합 유니크 제약 버전입니다. 1-8에서 본 두 가지 PK 설계 방식에 각각 대응합니다.
05JPA 내부 구조와 활용
JPA를 “어노테이션 붙이면 알아서 되는 마법”으로 쓰면 곤란합니다. Spring Data JPA는 많은 편의를 주는 만큼 많은 것을 가려 두었고, 내부 동작 때문에 의도치 않은 오류와 성능 문제가 생기기도 합니다.
5-1영속성 컨텍스트 · Entity 생명주기
핵심영속성 컨텍스트는 엔티티를 관리하는 환경입니다. 엔티티는 비영속 → 영속 → 준영속 / 삭제 상태를 오가며, 영속 상태일 때만 JPA가 변경을 추적합니다.
이론
영속성 컨텍스트(Persistence Context)
JPA는 엔티티를 단순히 조회·저장하는 데 그치지 않고, 영속성 컨텍스트를 통해 엔티티의 상태와 변경 사항을 관리합니다.
네 가지 상태
비영속(Transient): 생성했지만 영속성 컨텍스트가 관리하지 않는 상태
영속(Managed): 영속성 컨텍스트가 관리하는 상태
준영속(Detached): 영속성 컨텍스트의 관리 대상에서 분리된 상태
삭제(Removed): 삭제가 예약된 상태
persist()
엔티티를 영속성 컨텍스트에 등록합니다. 실제 INSERT SQL의 실행 시점은 ID 생성 전략과 flush 시점 등에 따라 달라집니다. IDENTITY 전략에서는 식별자 생성을 위해 persist() 시점에 INSERT가 실행될 수 있습니다.
detach()
엔티티를 영속성 관리 대상에서 제외합니다. 준영속 엔티티는 DB에 데이터가 있다는 점에서 영속성은 보장되지만, 지금은 관리 대상이 아니므로 변경 사항이 반영되지 않습니다.
remove()
해당 엔티티를 영속성 컨텍스트가 삭제 대상으로 인식하게 만듭니다. 실제 삭제는 flush 시점에 이루어집니다.
비유
영속성 컨텍스트는 도서관 대출 관리 시스템입니다. 집에서 산 책(비영속)은 시스템이 모르고, 등록된 책(영속)은 상태가 추적되며, 등록 해제된 책(준영속)은 실물은 있지만 추적되지 않고, 폐기 예정 책(삭제)은 정리 시간(flush)에 실제로 빠집니다.
예시
Member member = new Member();  // 비영속

entityManager.persist(member); // 영속

entityManager.detach(member);  // 준영속

entityManager.remove(member);  // 삭제 상태
기술 도메인
Spring Data JPA의 save()는 새 엔티티면 persist(), 이미 ID가 있으면 merge()를 호출합니다(6장 실습). merge()는 준영속 엔티티의 값을 새로 조회한 영속 엔티티에 복사해 반환하므로, 이후에는 반환값을 써야 합니다.
테이블
Entity 생명주기
상태
의미
비영속(Transient)
생성했지만 영속성 컨텍스트가 관리하지 않는 상태
영속(Managed)
영속성 컨텍스트가 관리하는 상태
준영속(Detached)
영속성 컨텍스트의 관리 대상에서 분리된 상태
삭제(Removed)
삭제가 예약된 상태
보완원문 예시처럼 detach()한 엔티티에 바로 remove()를 호출하면 실제로는 IllegalArgumentException이 납니다(remove는 영속 엔티티에만 가능). 예시는 “각 메서드가 만드는 상태”를 보여 주는 개념 코드로 읽으면 됩니다.
5-21차 캐시와 동일성 · 쓰기 지연
핵심1차 캐시는 영속 엔티티를 보관해 같은 컨텍스트 안에서 같은 인스턴스를 돌려주고, 쓰기 지연 SQL 저장소는 SQL을 모아 두었다가 flush 시점에 DB로 보냅니다.
이론
1차 캐시와 동일성 보장
영속성 컨텍스트는 관리 중인 엔티티를 “1차 캐시”라는 저장소에 보관합니다. 같은 영속성 컨텍스트에서 같은 엔티티를 조회하면 같은 Java 객체 인스턴스를 반환하므로, 컨텍스트 범위 안에서 객체의 동일성을 보장합니다(3-3의 동일성 문제 해결).
쓰기 지연
JPA는 엔티티 변경 사항을 즉시 SQL로 실행하지 않고, 쓰기 지연 SQL 저장소에 모아 두었다가 flush 시점에 DB로 전달합니다. persist()를 두 번 호출했다고 각 호출 직후 INSERT가 실행되는 것은 아닙니다. 다만 IDENTITY 전략처럼 식별자를 얻기 위해 INSERT가 조기에 실행되는 경우도 있습니다.
1차 캐시 vs 쓰기 지연 SQL 저장소
두 저장소 모두 물리적인 저장소가 아니라 영속성 컨텍스트 내부의 논리적인 저장소입니다. 1차 캐시는 영속성 관리 대상인 엔티티를 관리하고, 쓰기 지연 SQL 저장소는 1차 캐시의 엔티티 상태를 DB에 반영하기 위한 SQL을 저장한다는 차이가 있습니다.
비유
1차 캐시는 책상 위에 꺼내 둔 서류(다시 찾으면 같은 서류를 줌), 쓰기 지연 저장소는 보낼 우편물 바구니(모았다가 정해진 시간에 한 번에 발송)입니다.
예시
Member member1 = entityManager.find(Member.class, 1L);   // SELECT 실행 → 1차 캐시 저장
Member member2 = entityManager.find(Member.class, 1L);   // 1차 캐시에서 반환 (SQL 없음)

System.out.println(member1 == member2); // true
1차 캐시는 트랜잭션(요청) 범위의 짧은 캐시라 다른 요청과 공유되지 않습니다. 서버 전체에서 공유하는 캐시가 필요하면 Redis 같은 별도 캐시를 씁니다. 또 JPQL 조회(findAll 등)는 1차 캐시를 거치지 않고 항상 SQL을 실행한 뒤, 이미 캐시에 있는 엔티티는 캐시의 인스턴스를 돌려줍니다.
테이블
두 논리 저장소 비교
구분
1차 캐시
쓰기 지연 SQL 저장소
보관 대상
영속 엔티티 (ID → 인스턴스)
DB에 반영할 SQL
효과
동일성 보장, 같은 ID 반복 조회 시 SQL 생략
SQL을 모아 flush 시점에 전송
범위
영속성 컨텍스트 내부의 논리적 저장소
5-3변경 감지 · flush와 commit
핵심영속 엔티티의 필드를 바꾸면 JPA가 변경 감지(Dirty Checking)로 UPDATE를 만듭니다. flush는 SQL을 DB에 보내는 것이고, commit은 트랜잭션을 확정하는 것 — flush가 됐다고 확정된 것은 아닙니다.
이론
변경 감지(Dirty Checking)
영속 상태의 엔티티를 조회한 뒤 필드를 수정하면, JPA는 변경 사항을 감지해 UPDATE SQL을 생성할 수 있습니다. 엔티티가 계속 영속 상태로 관리되고 트랜잭션이 정상 처리되면 별도의 save() 호출 없이도 반영됩니다.
flush와 commit
flush(): 영속성 컨텍스트의 변경 사항을 DB에 SQL로 동기화(전달)
commit(): 트랜잭션을 최종 확정
일반적으로 트랜잭션 커밋 과정에서 flush가 발생하며, JPQL 실행 전이나 명시적인 flush() 호출로도 발생할 수 있습니다.
flush ≠ 확정
flush가 발생했다고 트랜잭션이 커밋된 것은 아닙니다. 이후 롤백되면 해당 변경도 롤백될 수 있습니다. 플러시가 성공했다는 사실만으로 DB 변경이 확정된 것은 아닙니다.
비유
flush는 원고를 편집부에 넘기는 것, commit은 인쇄 승인 도장입니다. 원고를 넘겨도 승인 전에 취소(롤백)되면 책은 나오지 않습니다.
예시
Member member = entityManager.find(Member.class, 1L);
member.changeName("새로운 이름");
// save() 없이도 커밋 시점에 UPDATE member SET name = ? WHERE id = 1
// 커밋 흐름을 개념적으로 표현한 코드
public void save(S entity) {
    try {
        ...
        flush();  // 변경 사항을 SQL로 실행

        db.commit();  // 트랜잭션 커밋
    } catch (Exception e) {
        db.rollback();  // 실패 시 롤백
        throw e;
    }
}
기술 도메인
변경 감지는 영속화 시점에 떠 둔 스냅샷과 flush 시점의 현재 값을 비교해 동작합니다. 그래서 수정 API는 “조회 → 도메인 메서드로 값 변경”만으로 충분하며, 이를 위해 조회와 변경이 같은 트랜잭션 안에 있어야 합니다(6장 STEP 4).
테이블
flush vs commit
구분
flush
commit
하는 일
변경 사항을 SQL로 DB에 전달
트랜잭션을 최종 확정
발생 시점
커밋 과정, JPQL 실행 전, 명시적 flush()
트랜잭션 정상 종료
롤백 가능?
가능 (아직 미확정)
불가 (확정)
보완원문의 save(S entity) 코드는 커밋 흐름을 보여 주는 개념 코드입니다. 실제 SimpleJpaRepository.save()는 persist()/merge()만 호출하고 직접 flush·commit하지 않으며, flush와 commit은 트랜잭션 매니저가 트랜잭션 종료 시 수행합니다.
5-4트랜잭션과 영속성 컨텍스트
핵심서비스 계층에서는 Spring이 트랜잭션과 EntityManager를 연동해 함께 동작시킵니다. 하지만 둘은 다른 개념입니다 — 트랜잭션은 DB 작업의 확정, 영속성 컨텍스트는 엔티티 상태를 관리합니다.
이론
언제 생성되고 언제 종료될까?
@Transactional을 적용한 서비스 메서드의 일반적인 흐름은 다음과 같습니다.
Spring이 트랜잭션을 시작한다.
트랜잭션에 사용할 EntityManager를 준비한다.
해당 EntityManager를 통해 영속성 컨텍스트를 사용한다.
메서드가 끝나면 flush 및 커밋을 처리한다.
무조건 새로 생기지는 않는다
@Transactional 메서드가 호출될 때마다 새로운 영속성 컨텍스트가 생성되는 것은 아닙니다. 실제 생성·재사용·종료 시점은 트랜잭션 전파 설정, EntityManager 관리 방식 등에 따라 달라집니다.
세 가지 정리
EntityManager: JPA 엔티티를 조회하고 관리하는 API
영속성 컨텍스트: 엔티티의 상태와 변경 사항을 관리하는 논리적인 공간
트랜잭션: DB 작업을 하나의 단위로 처리하고 커밋 또는 롤백하는 경계
둘의 관계
일반적인 서비스 계층에서는 연동되어 동작하지만, 설정에 따라 서비스 계층의 트랜잭션이 끝난 후에도 요청 처리 동안 영속성 컨텍스트가 열려 있을 수 있습니다. 중요한 점은 트랜잭션은 DB 작업의 확정 여부를, 영속성 컨텍스트는 Entity의 상태와 변경 사항을 관리한다는 것입니다.
비유
트랜잭션은 계약서 서명 절차(확정·파기), 영속성 컨텍스트는 계약 담당자의 작업 책상입니다. 보통 서명 절차가 시작될 때 책상을 펴고 끝나면 정리하지만, 설정에 따라 서명이 끝난 뒤에도 책상이 펼쳐져 있을 수 있습니다.
예시
@Service
public class MemberService {

    private final MemberRepository memberRepository;

    public MemberService(MemberRepository memberRepository) {
        this.memberRepository = memberRepository;
    }

    @Transactional
    public void updateMemberName(Long memberId, String name) {
        Member member = memberRepository.findById(memberId)
            .orElseThrow();

        member.changeName(name);   // 메서드 종료 시 flush + commit → UPDATE
    }
}
기술 도메인
“트랜잭션이 끝난 뒤에도 영속성 컨텍스트가 열려 있는 설정”이 Spring Boot의 OSIV(spring.jpa.open-in-view, 기본 true)입니다. 켜져 있으면 Controller·View에서도 지연 로딩이 되지만 요청이 끝날 때까지 커넥션을 붙잡을 수 있어(2-4), 트래픽이 많은 서비스에서는 false로 두고 필요한 데이터를 Service 안에서 모두 조회하는 방식을 많이 씁니다.
테이블
트랜잭션 vs 영속성 컨텍스트
구분
트랜잭션
영속성 컨텍스트
목적
데이터베이스 작업의 원자성과 일관성 관리
Entity의 상태와 변경 사항 관리
주요 역할
커밋 또는 롤백
1차 캐시, 변경 감지, 쓰기 지연 등
종료
커밋 또는 롤백으로 트랜잭션 종료
EntityManager의 관리 방식과 설정에 따라 종료 시점이 달라질 수 있음
5-5즉시 로딩과 지연 로딩
핵심연관 엔티티를 함께 조회(EAGER)할지 필요할 때 조회(LAZY)할지 정해야 합니다. @ManyToOne·@OneToOne의 기본값은 EAGER이지만, 모든 연관관계는 LAZY를 기본으로 하고 필요할 때 Fetch Join 등으로 함께 가져옵니다.
이론
또 프록시
개발자가 비즈니스 로직에 집중하도록 편의를 제공하는 프레임워크 특성상 프록시가 정말 많이 쓰입니다. 하지만 이번에는 조금 다르게 동작합니다(5-6).
두 가지 로딩 방식
즉시 로딩(EAGER): Entity를 조회할 때 연관 Entity도 함께 조회하도록 요청
지연 로딩(LAZY): 연관 Entity가 실제로 필요할 때 조회
LAZY를 기본으로
현재 필요한 데이터만 조회해 불필요한 DB 조회와 데이터 로딩을 줄이기 위해 일반적으로 연관관계는 LAZY를 기본으로 씁니다. 그리고 실제 조회 요구에 맞춰 Fetch Join이나 EntityGraph를 활용하는 방식이 권장됩니다.
EAGER라고 SQL 하나는 아니다
즉시 로딩이라고 항상 하나의 SQL로 조회되지는 않습니다. 조회 방식과 구현체에 따라 추가 쿼리가 발생할 수 있습니다. 게시글 조회 시 작성자를 EAGER로 가져오면 Post에 Member가 left join될 것 같지만, 실제로는 Post와 Member에 각각 SELECT가 발생할 수 있습니다.
비유
EAGER는 뷔페(먹든 안 먹든 전부 담아 옴), LAZY는 코스 요리(필요한 접시만 그때그때 나옴)입니다. 다만 코스 요리도 손님 100명이 각자 주문하면 주방이 100번 움직입니다(5-7 N+1).
예시
@ManyToOne(fetch = FetchType.LAZY)
@JoinColumn(name = "member_id")
private Member member;
-- EAGER 기대: 한 번에
SELECT p.*, m.* FROM post p LEFT JOIN member m ON p.member_id = m.id WHERE p.id = 1;
-- 실제로 나갈 수 있는 SQL (JPQL 조회 시)
SELECT * FROM post WHERE ...;
SELECT * FROM member WHERE id = ?;
기술 도메인
em.find()/findById는 Hibernate가 EAGER 연관을 JOIN으로 가져오는 경우가 많지만, JPQL(findAll, 쿼리 메서드)은 JPQL대로 먼저 실행한 뒤 EAGER 연관을 별도 SELECT로 채웁니다. 같은 EAGER 설정이라도 조회 방법에 따라 SQL이 달라지는 이유입니다.
테이블
로딩 방식
방식
설명
즉시 로딩(EAGER)
Entity를 조회할 때 연관 Entity도 함께 조회하도록 요청합니다.
지연 로딩(LAZY)
연관 Entity가 실제로 필요할 때 조회하도록 합니다.
연관관계별 기본 fetch 전략
연관관계
기본 fetch 전략
@ManyToOne, @OneToOne
EAGER ⚠️
@OneToMany, @ManyToMany
LAZY
5-6엔티티 프록시와 LazyInitializationException
핵심지연 로딩은 실제 엔티티 대신 식별자만 가진 프록시를 넣어 두었다가, 데이터에 처음 접근할 때 조회합니다. 이 조회에는 영속성 컨텍스트가 필요해서, 컨텍스트가 닫힌 뒤 접근하면 LazyInitializationException이 납니다.
이론
엔티티 프록시
게시글을 조회했을 때 작성자 정보가 필요하지 않다면, JPA는 작성자 엔티티를 즉시 조회하지 않고 프록시를 사용할 수 있습니다. 트랜잭션 프록시와 같은 디자인 패턴이지만 완전히 다르게 활용됩니다.
트랜잭션 프록시와의 차이
트랜잭션 프록시는 반복 로직(시작·커밋)을 호출하는 반면, 엔티티 프록시는 식별자와 초기화되지 않은 객체를 포함하고, 초기화되지 않은 객체의 데이터에 접근할 때 데이터를 로딩합니다.
id는 이미 알고 있다
식별자를 미리 가져올 수 있는 이유는 Post가 연관관계의 주인이라 FK로 참조 중인 memberId를 이미 가지고 있기 때문입니다. 따라서 Member의 id에만 접근하는 상황에서는 추가 로딩이 발생하지 않을 수 있습니다.
⚠️ 프록시의 동작은 접근하는 메서드와 JPA 구현체에 따라 차이가 있어 설명과 다르게 동작할 수도 있습니다!
지연 로딩과 영속성 컨텍스트
트랜잭션 안에서 게시글을 조회하고 작성자 이름에 접근하면 문제가 없습니다. 하지만 트랜잭션과 영속성 컨텍스트가 종료된 뒤에 지연 로딩을 시도하면 LazyInitializationException이 발생할 수 있습니다. JPA로 데이터에 접근하려면 반드시 영속성 컨텍스트를 거쳐야 하기 때문입니다. 따라서 연관 Entity가 실제로 필요한 위치와 영속성 컨텍스트의 생명주기를 함께 고려해야 합니다.
비유
프록시는 도서관 책 대신 꽂아 둔 청구 카드입니다. 카드에는 책 번호(id)만 있고, 내용을 읽으려 하면 그때 서고에서 책을 가져옵니다. 도서관(영속성 컨텍스트)이 문을 닫은 뒤에는 카드로 책을 가져올 수 없습니다.
예시
// 엔티티 프록시를 개념적으로 표현한 코드
class MemberProxy {

    private Long memberId;
    private Member target; // 실제 엔티티

    public String getName() {
        if (target == null) {
            target = loadMemberFromDatabase(memberId);
        }

        return target.getName();
    }
}
@Transactional
public String getMemberName(Long postId) {
Post post = postRepository.findById(postId)
.orElseThrow();
return post.getMember().getName(); // 트랜잭션 안 → 지연 로딩 OK
}
// 트랜잭션 밖(OSIV off)에서 post.getMember().getName() 호출 시// → LazyInitializationException: could not initialize proxy - no Session
기술 도메인
Hibernate 프록시는 엔티티 클래스를 상속한 런타임 클래스(Member$HibernateProxy$…)라서, 엔티티 클래스를 final로 만들면 안 되고 getClass() 비교 대신 instanceof를 써야 합니다. 해결책은 Service 안에서 필요한 연관 데이터를 함께 조회(Fetch Join)하고 DTO로 변환해 반환하는 것입니다.
5-7N+1 문제
핵심1번의 쿼리로 N개 엔티티를 가져온 뒤, 각 엔티티의 연관 데이터를 조회하느라 추가 쿼리가 N번 나가는 문제입니다. EAGER로 바꿔도 해결되지 않고, 오히려 연관 엔티티를 쓰지 않아도 발생해 더 치명적입니다.
이론
JPA의 대표적인 함정
N+1은 JPA 자체의 버그가 아니라 ORM이 객체의 연관관계를 조회하는 방식과 실제 SQL 실행 방식의 차이에서 생깁니다. JPA의 편리한 기능을 쓰면서 오류와 성능 저하를 예방하려면 앞의 내용들을 잘 알고 대처할 수 있어야 합니다.
발생 과정
게시글(Post)과 작성자(Member)가 N:1인 상황에서 게시글 목록 API를 만들면, 응답을 만들며 작성자 정보에 접근할 때마다 Member 지연 로딩이 발생합니다. 게시글이 100개면 최대 101번의 쿼리가 실행됩니다(같은 작성자는 1차 캐시 덕분에 한 번만 조회되므로 “최대”).
EAGER로 바꾸면?
그래도 해결되지 않습니다. Spring Data JPA의 기본 메서드와 쿼리 메서드는 JPQL 기반으로 동작합니다.
JPQL은 개발자가 작성한 쿼리를 기준으로 먼저 엔티티를 조회해야 한다는 규칙이 있어, 로딩 방식과 관계없이 findAll()의 SELECT p FROM Post p를 먼저 실행합니다.
그 다음 로딩 방식에 따라 연관 엔티티를 조회합니다. 즉 조회 대상과 연관 엔티티를 분리해 순차적으로 쿼리하므로 JOIN을 쓰지 않는 상황이 됩니다.
결국 연관 엔티티를 안 쓰면 N+1이 없는 지연 로딩보다, 안 써도 N+1이 발생하는 즉시 로딩이 훨씬 치명적입니다.
비유
반 학생 명단(1번)을 받은 뒤, 학생마다 보호자 연락처를 교무실에 한 번씩 물어보러 가는 것(N번)입니다. 처음부터 “명단에 보호자 연락처도 붙여서 주세요”(Fetch Join)라고 하면 한 번에 끝납니다.
예시
@Transactional(readOnly = true)
public List<PostResponse> findAll() {
    List<Post> posts = postRepository.findAll();  // ① 게시글 조회 — 1번

    return posts.stream()
            .map(post -> new PostResponse(
                    post.getId(),
                    post.getTitle(),
                    post.getMember().getName()))  // ② 작성자 조회 — 게시글마다 1번씩!
            .toList();
}
SELECT * FROM post;                          -- 1번 (게시글 100개)
SELECT * FROM member WHERE id = 1;           -- 게시글 1의 작성자
SELECT * FROM member WHERE id = 2;           -- 게시글 2의 작성자
SELECT * FROM member WHERE id = 3;
...                                          -- N번 (최대 100번)
기술 도메인
N+1은 개발 환경(데이터 몇 건)에서는 티가 안 나다가 운영 데이터에서 터집니다. show-sql 로그에서 같은 모양의 SELECT가 반복되는지 확인하고, 테스트에서 실행된 쿼리 수를 세어 검증하는 습관이 좋습니다. 해결 방법은 5-8에서 다룹니다.
핵심FETCH JOIN은 연관 엔티티를 JOIN으로 한 번에, @EntityGraph는 어노테이션으로 함께 가져올 연관을 지정, Batch Fetch는 연관 데이터를 IN으로 묶어 조회합니다.
이론
FETCH JOIN
JPQL에서 연관된 엔티티를 JOIN으로 한 번에 가져오라고 명시합니다. 순서는 중요하지 않습니다(JOIN FETCH == FETCH JOIN). 연관 데이터를 쓸 때 반복 조회를 줄이는 데 유용합니다.
컬렉션 FETCH JOIN의 주의점
한 게시글에 여러 연관 데이터가 연결된 경우 결과 행이 늘어날 수 있습니다. 예를 들어 게시글-댓글 같은 @OneToMany에서 게시글이 참조하는 댓글 컬렉션을 FETCH JOIN하면 모든 댓글을 함께 조회합니다. 이때 페이징을 적용하면 필요한 데이터만 조회하는 것이 아니라 전체 데이터를 조회한 뒤 메모리에서 페이징합니다.
@EntityGraph
특정 조회에서 함께 가져올 연관 Entity를 지정해 Fetch 계획을 정합니다. 실제 SQL의 JOIN 방식은 구현체와 쿼리 형태에 따라 다를 수 있으며, Hibernate는 내부적으로 LEFT OUTER JOIN을 사용합니다. 이는 LEFT FETCH JOIN을 SQL로 변환한 결과와 같습니다.
Batch Fetch
여러 Entity의 연관 데이터를 묶어 조회해 반복 쿼리를 줄입니다. 게시글 100개 각각의 작성자를 개별 조회하는 대신 여러 작성자를 한 번의 쿼리로 조회합니다. 실제 적용 방식과 효과는 연관관계 구조와 Hibernate 설정에 따라 달라지며, 전역 설정(default_batch_fetch_size)도 가능합니다.
비유
FETCH JOIN은 명단에 보호자 연락처를 붙여서 한 장으로 받기, Batch Fetch는 “1~100번 학생 보호자 연락처 한꺼번에 주세요”라고 묶어서 묻기입니다. 둘 다 교무실 왕복 횟수를 줄입니다.
예시
FETCH JOIN
@Query("SELECT p FROM Post p JOIN FETCH p.member")
List<Post> findAllWithMember();
SELECT p.*, m.*
FROM post p
INNER JOIN member m ON p.member_id = m.id;   -- 1번으로 끝!
SELECT * FROM post;                                         -- 1번
SELECT * FROM member WHERE id IN (1, 2, 3, ..., 100);
SELECT * FROM member WHERE id IN (101, 102, 103, ..., 200); -- 2번
기술 도메인
실무 조합: ToOne 관계는 FETCH JOIN으로 한 번에, 컬렉션(ToMany)은 지연 로딩 + default_batch_fetch_size로 IN 조회 — 이렇게 하면 페이징도 DB에서 정상 동작합니다. FETCH JOIN은 기본이 INNER JOIN이라 작성자가 없는 게시글은 결과에서 빠질 수 있으니, 필요하면 LEFT JOIN FETCH를 씁니다.
테이블
N+1 해결 방법 비교
방법
쿼리 수
JOIN
주의점
FETCH JOIN
1
INNER (LEFT 지정 가능)
컬렉션 + 페이징 시 메모리 페이징
@EntityGraph
1
LEFT OUTER (Hibernate)
FETCH JOIN과 동일한 컬렉션 주의
Batch Fetch
1 + ⌈N / size⌉
없음 (IN 조회)
쿼리가 완전히 하나는 아님
보완① @BatchSize를 @ManyToOne필드에 붙이면 Hibernate에서 효과가 없습니다. ToOne 관계에 적용하려면 대상 엔티티 클래스(@BatchSize(size = 100) class Member)에 붙이거나 전역 설정을 써야 하고, 필드 위 @BatchSize는 컬렉션(@OneToMany)에 씁니다. ② 원문의 IN 쿼리 2번 예시는 서로 다른 작성자가 200명일 때의 결과입니다. 게시글이 100개라면 작성자는 최대 100명이므로 IN 쿼리는 1번입니다.
5-9동시성 제어 · 낙관적 락과 비관적 락
핵심여러 사용자가 같은 데이터를 동시에 수정하면 덮어쓰기 문제가 생깁니다. 낙관적 락은 @Version으로 커밋 시 충돌을 감지하고, 비관적 락은 DB 잠금으로 동시 접근 자체를 막습니다.
이론
낙관적 락
동시에 수정하는 상황이 자주 발생하지 않는다고 가정하고, 데이터 변경 시 충돌 여부를 확인합니다. 대표적으로 @Version을 사용하며, JPA가 수정 시 버전 정보를 확인해 다른 트랜잭션이 먼저 변경했다면 충돌을 감지합니다. 충돌 시 예외 처리나 재시도 정책을 적용하는 방식에 적합하지만, 충돌이 많으면 재시도가 늘어 성능 저하의 원인이 될 수 있습니다.
비관적 락
충돌 가능성이 높다고 보고 DB의 잠금 기능으로 동시 접근을 제어합니다. 일반적으로 PESSIMISTIC_WRITE는 해당 데이터를 수정하기 위한 잠금을 요청합니다. 다만 모든 일반 조회가 반드시 대기하는 것은 아니며, 실제 대기 여부와 잠금 범위는 DB 종류, 격리 수준, 쿼리 및 잠금 방식에 따라 달라집니다.
신중하게
비관적 락은 충돌 제어에 유용하지만 잠금 대기나 교착 상태 등의 문제를 일으킬 수 있으므로 필요한 범위에서 신중하게 사용해야 합니다. (레전드 오비 예지가 아티클로 잘 정리해 두었으니 해당 자료를 참고해 보세요!)
비유
낙관적 락은 위키 편집(누구나 편집하다가 저장할 때 “그 사이 다른 사람이 수정했습니다” 경고), 비관적 락은 회의실 예약(사용 중이면 다른 사람은 문 앞에서 기다림)입니다.
예시
@Entity
public class Post {
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Version
private Long version;
}
-- 수정 시 실행되는 SQL-- UPDATE post SET title = ?, version = 4 WHERE id = 1 AND version = 3-- 영향받은 행이 0이면 → OptimisticLockException
@Lock(LockModeType.PESSIMISTIC_WRITE)
@Query("SELECT p FROM Post p WHERE p.id = :id")
Optional<Post> findByIdForUpdate(@Param("id") Long id);
-- MySQL: SELECT ... FROM post WHERE id = ? FOR UPDATE
기술 도메인
게시글 수정처럼 충돌이 드문 곳은 낙관적 락 + 409 응답, 재고 차감·좌석 예약처럼 충돌이 잦고 정확해야 하는 곳은 비관적 락을 고려합니다. 조회수 증가처럼 단순 카운터는 UPDATE post SET view_count = view_count + 1 같은 원자적 UPDATE로 락 없이 해결할 수도 있습니다(0-3의 Atomic과 같은 발상).
테이블
낙관적 락 vs 비관적 락
구분
낙관적 락
비관적 락
가정
충돌이 드물다
충돌이 잦다
방법
@Version으로 수정 시 버전 비교
DB 잠금 (SELECT … FOR UPDATE)
충돌 시
예외 → 재시도/실패 응답
다른 트랜잭션이 대기
단점
충돌이 많으면 재시도 증가
잠금 대기, 교착 상태
06실습 · 데이터베이스 연결하기
세미나 내용을 바탕으로 2차 과제의 메모리 기반 저장소를 데이터베이스로 바꿉니다. 이번 실습은 진짜로 ㄹㅇㄹㅇ 너무 쉬운 과정이에요. 시작 전에 DBMS(MySQL)를 실행해 두세요!
STEP 1DB 생성 · 의존성 · 설정
핵심DB를 만들고, MySQL 드라이버 + Spring Data JPA 의존성을 추가한 뒤 application.yml에 datasource·JPA 설정을 넣으면 연결 준비는 거의 끝납니다.
이론
변경 사항
build.gradle: MySQL 드라이버 의존성 추가, Spring Data JPA 의존성 추가
src/main/resources/application.yml: JDBC의 datasource 설정 추가, Spring Data JPA 설정 추가
→ 드라이버와 프레임워크 의존성을 추가하고 설정한 것만으로 이미 연결할 준비는 거의 끝났습니다!
Gradle 동기화
gradle을 변경한 이후에는 IntelliJ 오른쪽의 코끼리 아이콘을 눌러 동기화해야 합니다.
연결 확인 로그
여기까지 하고 실행하면 HHH10001005: Database info 로그가 출력됩니다. JDBC가 DB와 정상적으로 연결된 이후 연결된 DB의 정보를 출력한 결과입니다(URL, 드라이버, 방언, 버전, 격리 수준 등).
비유
새 가전(드라이버)을 들이고 콘센트 위치·전압(datasource 설정)을 적어 두면, 전원을 켜는 순간 연결 상태 표시등(Database info 로그)이 들어옵니다.
예시
1) DB 생성
CREATE DATABASE assignment;
2) build.gradle
변경 전
plugins {
    id 'java'
    id 'org.springframework.boot' version '4.0.8'
    id 'io.spring.dependency-management' version '1.1.7'
}

group = 'org.sopt'
version = '1.0-SNAPSHOT'

repositories {
    mavenCentral()
}

dependencies {
    implementation 'org.springframework.boot:spring-boot-starter-webmvc'
    testImplementation 'org.springframework.boot:spring-boot-starter-webmvc-test'
    testImplementation platform('org.junit:junit-bom:6.0.0')
    testImplementation 'org.junit.jupiter:junit-jupiter'
    testRuntimeOnly 'org.junit.platform:junit-platform-launcher'
}

test {
    useJUnitPlatform()
}
변경 후
plugins {
    id 'java'
    id 'org.springframework.boot' version '4.0.8'
    id 'io.spring.dependency-management' version '1.1.7'
}

group = 'org.sopt'
version = '1.0-SNAPSHOT'

repositories {
    mavenCentral()
}

dependencies {
    implementation 'org.springframework.boot:spring-boot-starter-webmvc'
    testImplementation 'org.springframework.boot:spring-boot-starter-webmvc-test'

    // MySQL 드라이버
    runtimeOnly 'com.mysql:mysql-connector-j'

    // Spring Data JPA
    implementation 'org.springframework.boot:spring-boot-starter-data-jpa'

    testImplementation platform('org.junit:junit-bom:6.0.0')
    testImplementation 'org.junit.jupiter:junit-jupiter'
    testRuntimeOnly 'org.junit.platform:junit-platform-launcher'
}

test {
    useJUnitPlatform()
}
INFO 12784 --- [assignment] [           main] org.hibernate.orm.connections.pooling    : HHH10001005: Database info:
    Database JDBC URL [jdbc:mysql://localhost:3306/assignment]
    Database driver: MySQL Connector/J
    Database dialect: MySQLDialect
    Database version: 8.4.10
    Default catalog/schema: assignment/undefined
    Autocommit mode: undefined/unknown
    Isolation level: REPEATABLE_READ [default REPEATABLE_READ]
    JDBC fetch size: none
    Pool: DataSourceConnectionProvider
    Minimum pool size: undefined/unknown
    Maximum pool size: undefined/unknown
기술 도메인
드라이버는 컴파일 시 인터페이스(java.sql)만 필요하므로 runtimeOnly로 추가합니다(2-1). 로그의 Isolation level: REPEATABLE_READ는 MySQL InnoDB의 기본 격리 수준(1-13)이고, Pool: DataSourceConnectionProvider는 Spring이 만든 HikariCP DataSource를 Hibernate가 사용한다는 뜻입니다(2-3).
테이블
application.yml 설정 항목
키
의미
spring.datasource.url
접속할 DB 주소 (호스트:포트/DB 이름)
username / password
DB 계정
driver-class-name
사용할 JDBC 드라이버 클래스
jpa.hibernate.ddl-auto
엔티티 기준 테이블 자동 생성·변경 (update)
jpa.show-sql
실행되는 SQL을 콘솔에 출력
hibernate.dialect
DB 방언 (MySQL 문법으로 SQL 생성)
hibernate.format_sql
출력 SQL을 보기 좋게 줄바꿈
보완① DB 비밀번호는 깃허브에 올라가지 않도록 ${DB_PASSWORD} 같은 환경 변수나 git에서 제외한 설정 파일로 분리하는 것이 안전합니다(다음 주 배포 전 필수). ② Hibernate 6 이상은 연결된 DB에서 방언을 자동 감지하므로 dialect 설정은 생략해도 되며, 명시하면 경고 로그가 나올 수 있습니다.
STEP 2엔티티 만들기와 테이블 자동 생성
핵심기존 Post 클래스에 @Entity · @Id · @GeneratedValue · 기본 생성자를 추가하면, ddl-auto: update가 매핑될 테이블을 자동으로 만듭니다.
이론
엔티티로 바꾸기 위해 추가한 것
JPA에 해당 클래스가 테이블과 매핑되는 객체임을 알리는 @Entity
테이블에서 사용할 식별자임을 알리는 @Id
식별자 자동 생성을 위한 @GeneratedValue와 생성 전략 옵션
JPA가 리플렉션에 사용할 기본 생성자
테이블 자동 생성
다시 실행하면 create table post 로그가 추가됩니다. 엔티티가 추가되어 매핑할 테이블을 자동 생성하는 과정의 DDL이 출력된 것입니다. 아직 DB만 만들고 테이블은 만들지 않았지만, 엔티티가 동작하려면 매핑될 테이블이 있어야 하므로 ddl-auto: update 옵션으로 테이블이 자동 생성되었습니다.
운영 환경에서는
자동 생성은 개발·테스트 환경에서만 쓰고, 실제 운영 환경에서는 의도치 않은 변경을 예방하기 위해 직접 DDL을 사용합니다.
비유
설계도(엔티티)만 제출하면 시공사(Hibernate)가 빈 땅(DB)에 건물(테이블)을 지어 줍니다. 하지만 사람이 사는 건물(운영)은 시공사가 마음대로 증축하지 못하게 설계 변경을 직접 승인합니다.
예시
@Entity
public class Post {
    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    private String title;

    private String content;

    protected Post() {}

    public Post(String title, String content) {
        this.title = title;
        this.content = content;
    }

    ...
}
Hibernate:
    create table post (
        id bigint not null auto_increment,
        content varchar(255),
        title varchar(255),
        primary key (id)
    ) engine=InnoDB
기술 도메인
별도 @Column이 없으면 문자열은 varchar(255), NULL 허용으로 만들어집니다. 제목 길이 제한·필수 여부가 있다면 @Column(nullable = false, length = …)로 스키마에도 반영합니다(4-1).
테이블
ddl-auto 옵션
값
동작
사용처
create
시작 시 테이블 삭제 후 재생성
로컬 실험
create-drop
create + 종료 시 삭제
테스트
update
변경분만 추가 (컬럼 삭제는 안 함)
개발
validate
엔티티와 테이블이 맞는지 검증만
운영
none
아무것도 하지 않음
운영
STEP 3Repository로 전환하기
핵심JpaRepository를 상속한 인터페이스를 만들고, Service의 메모리 저장소 사용 코드를 PostRepository 호출로 바꿉니다. 기본 CRUD 메서드에는 이미 트랜잭션이 적용되어 있습니다.
이론
남은 일: 쿼리 실행
이제 실제로 DB에 쿼리를 실행해 데이터를 가져오는 일만 남았습니다. 먼저 JpaRepository를 상속받는 인터페이스를 만듭니다.
생략 가능한 것들
@Repository는 생략할 수 있습니다. Spring Data JPA가 JpaRepository를 상속받는 인터페이스를 자동으로 Bean으로 등록하기 때문입니다.
예시 인터페이스에 선언한 메서드도 기본 제공 함수라 생략해도 사용할 수 있습니다.
Service 교체
비즈니스 로직에서 메모리 저장소를 쓰던 로직을 PostRepository를 쓰는 메서드로 바꿔 줍니다.
트랜잭션 어노테이션을 안 붙였는데 왜 되죠?
JpaRepository의 기본 CRUD 메서드에는 기본적으로 트랜잭션이 적용되어 있습니다. 조회 메서드는 일반적으로 읽기 전용 트랜잭션으로, 저장·삭제 메서드는 일반 트랜잭션으로 실행됩니다. 하지만 트랜잭션을 명시하거나 여러 로직으로 구성된 메서드를 하나의 트랜잭션으로 묶고 싶다면 Service 메서드에 어노테이션을 추가해야 합니다.
비유
창고 담당자(Repository)를 교체했을 뿐, 매장 직원(Service)이 “3번 물건 주세요”라고 말하는 방식은 거의 그대로입니다. 2차 세미나에서 저장소를 인터페이스 뒤에 숨겨 둔 덕분입니다.
Post post = postStore.findById(id)
        .orElseThrow(PostNotFoundException::new);
postStore.save(post);
변경 후 — JPA Repository
Post post = postRepository.findById(id)
        .orElseThrow(PostNotFoundException::new);
postRepository.save(post);
기술 도메인
기본 CRUD의 트랜잭션은 SimpleJpaRepository 클래스에 붙은 @Transactional(readOnly = true)와 save·delete 메서드의 @Transactional에서 옵니다. 즉 Repository 메서드 하나하나가 각자의 트랜잭션이며, Service에서 두 번 호출하면 트랜잭션도 두 개가 됩니다 — 이것이 STEP 4의 문제로 이어집니다.
STEP 4트랜잭션 경계와 변경 감지
핵심변경 감지는 영속 상태에서 바꾼 엔티티에만 동작합니다. 조회와 수정을 @Transactional로 하나의 트랜잭션에 묶어야 메서드 종료 시 flush로 UPDATE가 반영됩니다.
이론
꼭 붙여야 하는 경우 — 수정
영속성 컨텍스트의 더티 체킹으로 엔티티를 업데이트하면 상태가 알아서 반영될까요? 절대 아닙니다!updateTitle()은 JpaRepository가 제공하는 기본 CRUD 메서드가 아니라서 트랜잭션 밖에서 실행되기 때문입니다.
save()를 직접 호출하면?
직접 저장 메서드를 호출해 변경 상태를 반영할 수 있습니다. 이미 id에 값이 있는 post가 save()에 전달되므로 save()는 merge()로 실행됩니다. 하지만 여전히 영속성 컨텍스트의 더티 체킹이 적용되는 상황은 아닙니다. 처음 조회한 post는 조회가 끝나고 트랜잭션이 종료되면서 준영속 상태가 되어 관리 대상에서 제외되었기 때문입니다.
더티 체킹을 적용하려면
객체의 변경이 영속 상태에서 진행되어야 합니다. 조회와 변경을 하나의 트랜잭션으로 묶어 영속 상태를 유지하면, updatePost()가 종료될 때 flush가 발생하면서 변경된 상태가 알아서 반영됩니다.
트랜잭션의 경계는 늘 꼼꼼하게
변경 감지뿐 아니라 트랜잭션의 경계는 늘 꼼꼼하게 살펴봐야 합니다.
비유
회의(트랜잭션) 중에 화이트보드(영속성 컨텍스트)에 적은 수정 사항은 회의가 끝날 때 회의록(DB)에 자동 반영됩니다. 회의가 끝난 뒤 복도에서 메모를 고치면 회의록에는 반영되지 않습니다.
예시
✗ 트랜잭션 없음 — 반영 안 됨
public void updatePost(Long id, String title) {
    Post post = postRepository.findById(id)
            .orElseThrow(PostNotFoundException::new);

    post.updateTitle(title);
}
△ save() 직접 호출 — merge로 반영
public void updatePost(Long id, String title) {
    Post post = postRepository.findById(id)
            .orElseThrow();

    post.updateTitle(title);

    postRepository.save(post);   // id가 있으므로 merge()
}
✓ 하나의 트랜잭션 — 변경 감지
@Transactional
public void updatePost(Long id) {
    Post post = postRepository.findById(id).orElseThrow();

    post.updateTitle("변경된 제목");
}   // 종료 시 flush → UPDATE post SET title = ? WHERE id = ?
기술 도메인
조회만 하는 Service 메서드에는 @Transactional(readOnly = true)를 붙여 의도를 드러내고 Hibernate의 스냅샷·flush 비용을 줄입니다. Service 클래스에 @Transactional(readOnly = true)를 걸고 쓰기 메서드에만 @Transactional을 붙이는 패턴이 흔합니다. 2차 세미나에서 본 것처럼 @Transactional은 프록시 기반이라 같은 클래스 내부 호출(self-invocation)에는 적용되지 않는 점도 기억합니다.
테이블
세 가지 수정 방식 비교
방식
엔티티 상태
반영
실행 SQL
트랜잭션 없음, save 없음
조회 후 준영속(OSIV off 기준)
✗
SELECT만
트랜잭션 없음 + save()
merge로 새 영속 엔티티에 복사
✓
SELECT, SELECT, UPDATE
@Transactional
메서드 끝까지 영속
✓
SELECT, UPDATE
보완“조회가 끝나면 준영속이 된다”는 OSIV가 꺼져 있거나 HTTP 요청 밖일 때의 설명입니다. Spring Boot 기본값(open-in-view: true)에서 Controller를 거친 요청이라면 영속성 컨텍스트가 요청 끝까지 열려 있어 post는 계속 영속 상태입니다. 그래도 트랜잭션이 없으면 flush가 일어나지 않으므로 첫 번째 코드는 반영되지 않고, save()를 호출하면 그 트랜잭션의 커밋 시점에 변경 감지로 UPDATE가 나갑니다. 어느 경우든 결론은 같습니다 — 조회와 수정을 @Transactional 하나로 묶는 것이 의도가 분명하고 안전합니다.
마무리실습 마무리 · 다음 세미나 준비
핵심이제 DB를 구축하고 진짜 데이터를 저장하고 다룰 수 있는 서버를 만들 수 있습니다! 🥳 다음 세미나에서는 우리 컴퓨터 안에서만 쓸 수 있는 이 서버를 배포합니다.
이론
아직 진정한 서버가 아니다
지금까지 만든 서버는 우리 컴퓨터 안에서 우리만 사용할 수 있기 때문입니다. 다음 세미나에서는 서버를 배포합니다.